
Semantic Scholar
DataanalyseOpdateret 4. oktober 2026
Semantic Scholar er en gratis, AI-drevet søgemaskine, der bruger maskinlæring til at finde og opsummere videnskabelig forskning.
Vi kan modtage en provision, når du tilmelder dig via vores links. Det påvirker ikke vores anmeldelser.
Hvad er Semantic Scholar?
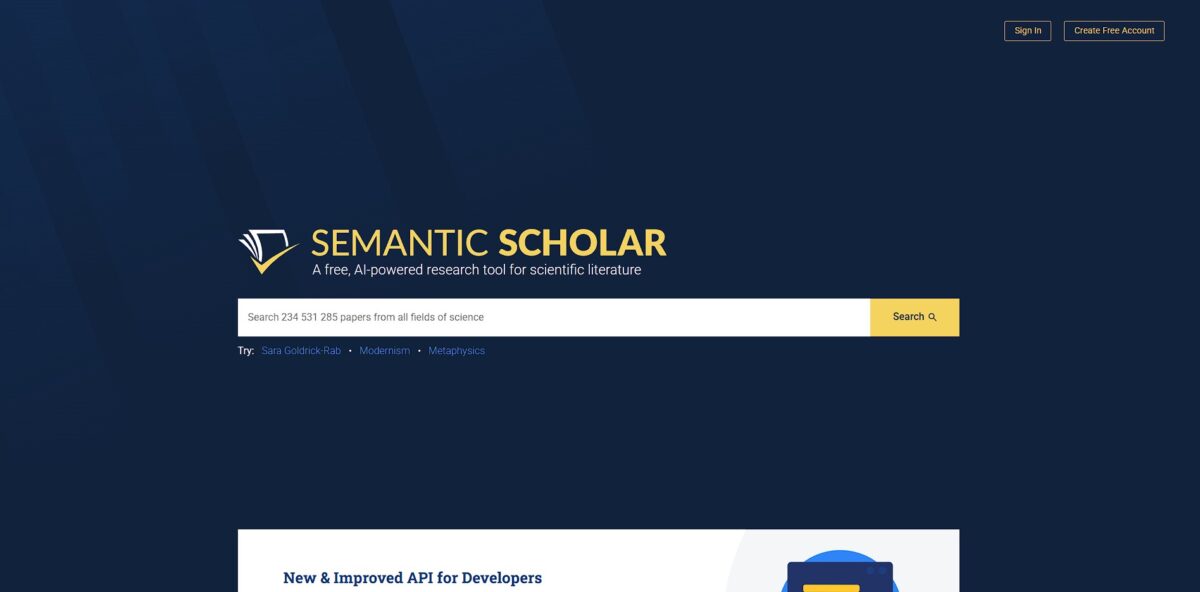
Semantic Scholar er en nonprofit søgemaskine fra Allen Institute for AI, der gennemsøger over 200 millioner artikler for at hjælpe dig med at springe det manuelle slid med at læse lange resuméer over. I stedet for blot at matche søgeord bruger den maskinlæring til at udtrække den faktiske hensigt bag citationer og markere, hvilke artikler der reelt har påvirket en undersøgelse, frem for blot at optræde på en liste. Jeg bemærkede, at den er særligt god til at fremhæve “TLDR”-resuméer inden for datalogi og biomedicin, selvom dækningen af nicheområder inden for humaniora kan føles tyndere. Denne semantiske tilgang hjælper dig med at kortlægge et forskningsfelts udvikling uden at drukne i de tre millioner artikler, der udgives årligt. Det forvandler en mur af tekst til en overskuelig graf over forbindelser, du kan navigere i, så du hurtigere kan finde de “vigtigste læsninger”.
Sådan kommer du i gang med Semantic Scholar
Start med at gå til semanticscholar.org for at teste søgefeltet. Du behøver ikke en konto for at gennemse deres korpus på over 200 millioner artikler, hvilket er fantastisk til hurtige faktatjek. Skriv et specifikt emne, og se efter TLDR-mærkerne i resultaterne. Disse resuméer på én sætning hjælper dig med at springe irrelevante PDF’er over uden at åbne dem.
For at få mere ud af søgemaskinen skal du klikke på Opret gratis konto øverst til højre. Du kan bruge Google eller din institutionelle e-mail. Dette låser op for Biblioteksfunktionen, hvor du kan gemme artikler i specifikke mapper. Dette forhindrer, at din forskning bliver til en stor, uorganiseret bunke af browserfaner.
Når du har gemt et par artikler, skal du slå Research Feed til for disse mapper. AI’en analyserer dine gemte artikler for at anbefale nye, relevante preprints og artikler dagligt. Det føles som en personlig opdagelseskø, der lærer dine nicheinteresser at kende. Dette sparer dig for manuelt at gentage de samme søgeord hver uge.
Hvis du er forfatter, kan du finde dit navn i søgeresultaterne og vælge Claim Author Page. Dette lader dig rydde op i dit publikationsregister ved at fjerne artikler, du ikke har skrevet, eller tilføje manglende. Du får også notifikationer, når nogen citerer dit arbejde. Det er en nem måde at spore dit akademiske fodaftryk på uden at betale for et citationsværktøj.
Siden er fremragende til at finde open-access PDF’er, men nogle gange adskiller antallet af “Highly Influential Citations” sig fra Google Scholar. Dette sker, fordi de fokuserer på specifikke datakilder frem for hele nettet. Brug den som et opdagelsesværktøj først, og verificer derefter citationsantal andre steder, hvis du har brug for total præcision.
Hvem er det til?
Studerende på kandidatniveau, der står over for et bjerg af PDF’er
TLDR-funktionen udtrækker resuméer på én sætning fra komplekse datalogi- eller biologiartikler, hvilket sparer dig for at læse hele resuméer bare for at se, om en undersøgelse er relevant. Du bruger langt mindre tid på at filtrere støj fra under en litteraturgennemgang.
PhD-kandidater, der sporer specifikke idétråde
Indflydelsesscorer fremhæver, hvilke citationer der reelt formede en artikels retning, i stedet for blot at være en forbigående omtale i introduktionen. At kende en artikels “indflydelse” hjælper dig med at kortlægge den faktiske udvikling af et koncept over årtier. Du farer ikke vild i et hav af generiske citationer.
Akademiske udviklere, der bygger videnskabelige apps
Det åbne API giver stabil adgang til en enorm graf af artikelmetadata og citationsforbindelser uden de adgangsbarrierer, som ældre databaser har. Du kan bygge tilpassede forskningsværktøjer eller datavisualiseringer ved hjælp af deres indekserede datasæt. Det er netop de rådata, der er nødvendige for at innovere inden for open science-området.
Forskere tidligt i karrieren, der kæmper med informationsoverflod
Personlige forskningsfeeds foreslår nye artikler baseret på, hvad du har gemt i dine biblioteksmapper, og fungerer som en opdagelsesmaskine, der lærer din niche at kende. Det automatiserer “morgensøgningen”, så du ikke går glip af et gennembrud i et felt i hastig udvikling som AI. At holde sig opdateret bliver en baggrundsproces i stedet for en manuel opgave.
Samarbejdende forskningslaboratorier
Delte mapper giver teams mulighed for at samle relevante kilder og eksportere citationer samlet, hvilket holder alle opdateret under et gruppeprojekt. Det bygger bro mellem individuel opdagelse og teamvidensstyring. Farvel til “så du den ene artikel?”-e-mailkæderne.
Uafhængige forskere med et begrænset budget
Platformen tilbyder gratis adgang til over 200 millioner artikler inden for STM og samfundsvidenskab, hvilket giver et professionelt alternativ til dyre proprietære indekser. Du får avancerede NLP-funktioner uden et universitetssubsidieret abonnement. Avancerede videnskabelige opdagelsesværktøjer holder op med at være et privilegium for velfinansierede institutioner.
Priser på Semantic Scholar
De fleste akademiske søgemaskiner ender med at gemme de bedste funktioner bag en betalingsmur, men Semantic Scholar forbliver åben. Da den er finansieret af Allen Institute for AI, får du adgang til dybdegående citationskortlægning og artikelresuméer uden abonnement.
Kerneplatformen er gratis for alle.
Ingen omkostninger til standardforskning. Offentlige endpoints deler en hastighedsgrænse på 1000 forespørgsler i sekundet på tværs af alle brugere uden API-nøgle.
Tilgængeligt via aftale. Selvom siden ikke oplyser nogen prisniveauer, skal udviklere, der har brug for dedikeret kapacitet (fra 1 forespørgsel i sekundet), ansøge om en API-nøgle.
Åben. Du kan downloade bulk-datasættet til lokal analyse uden at betale licensgebyrer. Du kan bygge tilpassede forskningsværktøjer eller scripts uden at bekymre dig om en månedlig regning. Selvom API’et er gratis, kan adgangen uden nøgle blive begrænset i myldretiden, så skaf en gratis API-nøgle, hvis du planlægger at skrabe data til et projekt.
Vigtigste funktioner i Semantic Scholar
AI-genererede TL;DR-resuméer fastslår artiklens hovedbidrag i én enkelt sætning
Du kan skimme snesevis af søgeresultater uden at åbne masser af faner for at finde kernetesen. Det forebygger den mentale træthed ved at læse tætte abstracts bare for at se, om et studie er relevant. Vælg den artikel, hvis enlinjers resumé passer bedst, når du skal grave dig ned.
Motoren prioriterer indflydelsesrige citationer frem for rå tal ved at genkende, når en artikel bygger videre på tidligere arbejde i stedet for blot at nævne det. Du ser, hvilke studier der faktisk rykkede noget i dit felt. Det hjælper dig med at springe »baggrundsstøjen« over og koncentrere dig om den grundlæggende litteratur, der formede de nuværende metoder. Brug filteret “Highly Influential Citations” for at finde sværvægterne.
Automatiske forskningsfeeds foreslår nye preprints ud fra dit biblioteks specifikke faglige fokus
Det fanger nicheartikler, som brede søgeordsalarmer ofte overser. Det sparer dig for manuelle ugentlige søgninger på tværs af spredte tidsskrifter. Kig i dit bibliotek hver uge for at se, hvordan anbefalingerne udvikler sig, efterhånden som du tilføjer flere kilder.
Semantic Reader fremhæver nøglebegreber og citationer direkte i teksten, mens du læser PDF’en
Den henter definitioner og krydshenvisninger frem, uden at du skal rulle ned til litteraturlisten. Det holder dig i flow, når du støder på ukendte forkortelser eller kompliceret matematik. Hold musen over en henvisning for straks at se dens abstract i stedet for at navigere væk.
Platformen linker direkte til open access-versioner og til de GitHub-arkiver, der hører til forskningen
Du kan springe fra en teoretisk påstand til den faktiske implementering eller rådata med to klik. Det bygger bro mellem at læse om en metode og at forsøge at gentage den. Kig efter Code-knappen for at se, om forfatterne har offentliggjort deres kode.
Forfattersider samler indflydelse gennem hele karrieren og samarbejdsnetværk på tværs af millioner af profiler
Det er lettere at vurdere en forskers konsistens og finde de hyppige medforfattere for at få et bredere billede af et laboratoriums produktion. Det giver kontekst til, om et gennembrud er en enlig svale eller del af et vedvarende forskningsprogram. Følg en hovedforfatter for at holde øje med kommende arbejde på tværs af forskellige publikationssteder.
Fordele og ulemper ved Semantic Scholar
Fordele
Semantic Scholar skærer kraftigt ned på tiden med at afkode akademisk jargon ved at vise et TLDR på én sætning for millioner af artikler. I stedet for at åbne tyve faneblade for at læse tunge resuméer kan du skimme en resultatside og finde de studier, der faktisk understøtter din tese. Jeg bemærkede, at filteret „Highly Influential Citations“ effektivt luger de forbigående omtaler ud og fremhæver kun den forskning, der reelt flyttede et felt. Det er vigtigt, fordi det forhindrer dig i at bygge en litteraturliste på overfladiske henvisninger. Det fungerer godt til hurtig kortlægning af litteratur inden for datalogi og biologi, selv om dækningen svinger i nicheprægede humaniora. Tjek uddragene med citatkontekst for at se, om en artikel blev støttet eller bestridt, før du citerer den.
Ulemper
Biblioteksdelen virker nøgtern og mangler de dybe PDF-annoteringsfunktioner, man finder i dedikerede referenceværktøjer. AI-anbefalingerne i Research Feeds holder sig relevante, men motoren overser undertiden de nyeste preprints, der endnu ikke er indekseret i hovedkorpusset. Prisen for hastigheden er en søgeflade, der kan virke rodet, når flere AI-genererede elementer kæmper om pladsen, og en travl brugerflade kan distrahere dig, når du leder efter en bestemt kendt titel og ikke er i opdagelsestilstand. Den er mindre velegnet til forskere, der har brug for et primært lager til tusindvis af lokale filer. Brug den som opdagelseslag frem for som dit eneste værktøj til dokumentstyring.
Brug Semantic Scholar, hvis du vil…
- AI, der afdækker skjulte forbindelser på tværs af millioner af artikler
- At gå uden om søgeordsmatchning og få ægte semantiske søgeresultater
- Resuméer på én sætning, så du hurtigt kan sortere i din læseliste
- Automatiseret citationssporing til at overvåge din forskningsindflydelse
- At opdage indflydelsesrige artikler via smart, datadrevet rangering
- En personlig strøm af de nyeste videnskabelige gennembrud
- At identificere trendende forskningsemner, før de bliver mainstream
Alternativer til Semantic Scholar
Anmeldelser af Semantic Scholar
Det bedste tilgængelige litteratursøgningsværktøj; AI-resuméerne sparer mig for timevis af læsning.
Ofte stillede spørgsmål
Hvordan beregner Semantic Scholar citationstal?
Semantic Scholar identificerer citerende artikler baseret på de data, der er tilgængelige i dets korpus, som primært fokuserer på publicerede akademiske artikler og preprints. Citationstal kan afvige fra andre sider, fordi dækningen af bøger er begrænset, og patenter ikke er inkluderet.
Hvad er et TLDR-resumé?
TLDR’er er ekstremt korte resuméer genereret ved hjælp af kunstig intelligens, som fremhæver hovedformålet og resultaterne af en artikel. De er designet til at hjælpe forskere med hurtigt at skimme artikler for at afgøre, om de er relevante for deres arbejde.
Hvordan bestemmes H-indekset på platformen?
H-indekset beregnes ud fra de citationsdata, der kan findes i Semantic Scholar-databasen. Det repræsenterer det højeste antal artikler, der hver især er blevet citeret mindst det samme antal gange.
Hvad er stærkt indflydelsesrige citationer?
Denne funktion bruger en maskinlæringsmodel til at identificere citationer, hvor den citerede publikation har haft en betydelig indflydelse på den citerende artikel. Den hjælper forskere med at filtrere gennem store mængder af citationer for at finde de mest meningsfulde forbindelser.
Kan jeg gemme og organisere forskningsartikler?
Ja, ved at oprette en gratis konto kan du gemme artikler i et personligt bibliotek, organisere dem i tilpassede mapper og dele disse mapper med samarbejdspartnere.
Hvad er Research Feeds?
Research Feeds er personlige, AI-drevne anbefalinger, der foreslår nye artikler baseret på de elementer, du har gemt i dine biblioteksmapper. Systemet lærer dine interesser, mens du vurderer relevansen af de foreslåede artikler.
Hvordan finder jeg mit Semantic Scholar-ID?
Du kan finde dit ID ved at søge efter din forfatterside på webstedet. ID’et er den numeriske streng, der findes i slutningen af URL’en for den pågældende forfatterside.
Er der værktøjer tilgængelige for udviklere?
Semantic Scholar tilbyder et RESTful API og datasættet Semantic Scholar Academic Graph (S2AG), som gør det muligt for udviklere at integrere akademisk indhold og citationsdata i deres egne applikationer.
Lignende værktøjer
 RowsRows er et AI-drevet regneark, der forbinder sig til værktøjer med realtidsdata for automatiseret analyse, klassificering og rapportering.
 AppenAppen leverer data af høj kvalitet med menneskelig annotering samt ekspertevaluering til at bygge og skalere præcise, pålidelige AI-modeller globalt.
 SciteScite AI er et smart citationsværktøj, der vurderer forskningens troværdighed ved at afsløre, om artikler understøtter eller modsiger påstande.