
Ollama
Entwickler-ToolsAktualisiert am 4. Oktober 2026
Ollama ist ein Open-Source-Framework für die lokale Ausführung großer Sprachmodelle unter macOS, Windows und Linux bei vollem Datenschutz.
Wenn Sie sich über unsere Links anmelden, erhalten wir möglicherweise eine Provision. Auf unsere Bewertungen hat das keinen Einfluss.
Was ist Ollama?
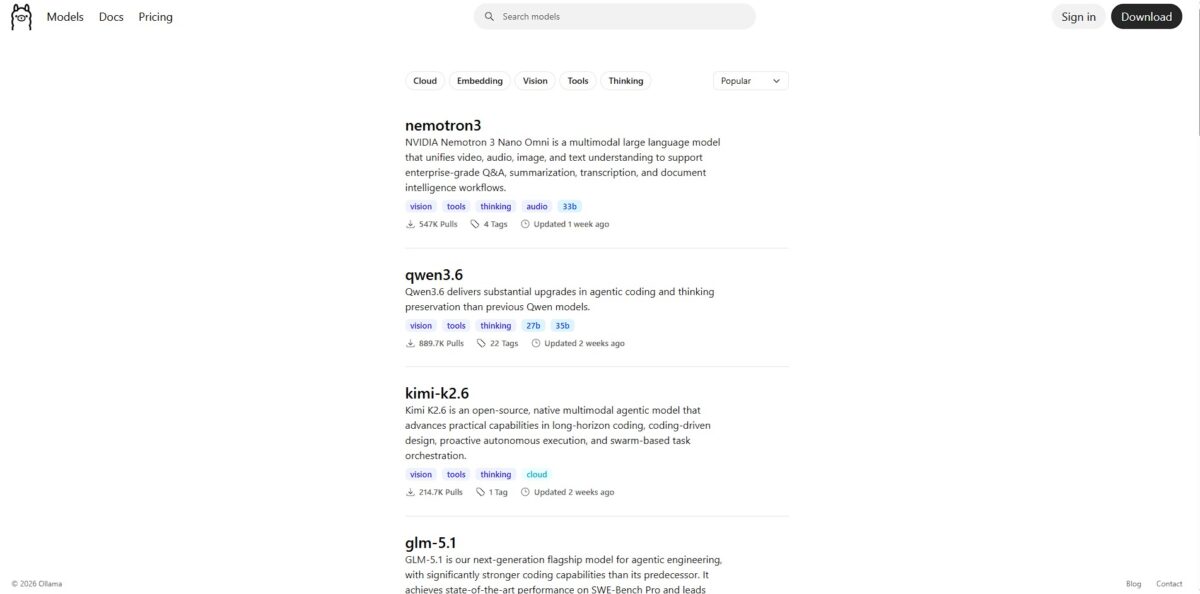
Ollama dient als schlanke Brücke, die große Sprachmodelle aus der Cloud auf Ihre lokale Hardware holt. Es bündelt Modellgewichte und Konfigurationen in einem einzigen, portablen Format, so dass Sie eine private Instanz von Llama 3 oder Mistral direkt von Ihrem Terminal aus starten können. Mir ist aufgefallen, dass die Speicherauslagerung intelligent gehandhabt wird. Wenn der VRAM Ihrer GPU voll ist, wird der Rest in den System-RAM verlagert, damit die Generierung nicht abstürzt. Dadurch entfallen die Latenzzeiten von Netzwerkaufrufen und die wiederkehrenden Kosten für API-Tokens, während Ihre Daten ausschließlich auf dem Gerät verbleiben. Ollama eignet sich hervorragend für die Erstellung von Offline-Coding-Assistenten oder die Verarbeitung sensibler Protokolle. Allerdings sinkt die Leistung auf Rechnern ohne einen dedizierten NVIDIA- oder Apple-Silicon-Chip erheblich. Entscheiden Sie sich für Ollama, wenn Sie über mindestens 16 GB RAM verfügen und Wert auf Datensouveränität legen, anstatt die absolut größten verfügbaren Modelle zu verwenden.
Wie fängt man mit Ollama an?
Holen Sie sich das Installationsprogramm für macOS oder Windows von der offiziellen Website. Linux-Benutzer erhalten ein Einzeiler-Curl-Skript, das die schwere Arbeit übernimmt. Die Windows-Installation richtet automatisch einen Hintergrunddienst ein, was praktisch ist, Sie aber überraschen könnte, wenn Sie bei Autostart-Programmen wählerisch sind. Dadurch wird die Engine zum Laufen gebracht, ohne dass Sie auch nur eine Zeile des Konfigurationscodes anfassen müssen, und Sie sparen sich die Mühe, Python-Umgebungen einzurichten, nur um mit einer KI zu kommunizieren.
Öffnen Sie Ihr Terminal und geben Sie ollama run llama3.2 ein. Wenn Sie dies zum ersten Mal tun, holt das Programm die Modellgewichte aus der Registry. Sie sehen einen Fortschrittsbalken, der sich bei einer guten Verbindung tatsächlich schnell bewegt. Sobald es fertig ist, erhalten Sie einen Chevron-Prompt („>>>“) für Ihre Fragen. So können Sie schnell die Logik eines Modells testen, bevor Sie eine App darauf aufbauen.
Für ein individuelles Erlebnis erstellen Sie ein Modelfile in Ihrem Projektordner. Sie können einen System-Prompt wie „Sie sind ein erfahrener Rust-Entwickler“ einbauen, damit Sie sich nicht bei jeder Sitzung wiederholen müssen. Verwenden Sie den Befehl ollama create my-assistant -f Modelfile, um Ihre spezielle Variante zu erstellen. Dadurch wird aus einem allgemeinen Modell ein gezieltes Werkzeug, das auf Ihre spezielle Codebasis oder Ihren Stil zugeschnitten ist. Spezialisierte Prompts verringern außerdem den Bedarf an langen, sich wiederholenden Anweisungen in jedem Chat.
Zur Integration stellen Sie in Ihrer IDE oder lokalen Web-UI in der Regel localhost:11434 als Adresse ein. Die meisten Tools wie Cursor oder AnythingLLM haben jetzt einen Schalter speziell für Ollama. Ich habe festgestellt, dass der Geschwindigkeitsunterschied zwischen einer NVIDIA-GPU und einer reinen CPU-Inferenz wie Tag und Nacht ist. Es funktioniert gut für private Entwürfe, aber rechnen Sie damit, dass Ihre Lüfter bei langen Generierungsaufgaben hochdrehen.
Für wen ist es geeignet?
Der Datenschutzbewusste
Wenn Sie mit proprietärer Logik oder Client-Protokollen arbeiten, ist das Senden von Daten an eine Cloud-API ein Risiko. Ollama speichert jedes Token auf Ihrer lokalen Festplatte, so dass Ihr Code nie Ihre Firewall verlässt. Das ist wichtig, weil so das Risiko ausgeschlossen wird, dass sensible Daten in die Trainingsdaten eines öffentlichen Modells gelangen.
Der Python-scheue Entwickler
Viele lokale LLM-Tools erfordern die Verwaltung komplexer virtueller Umgebungen oder bestimmter CUDA-Versionen. Ollama ist eine einzige Binärdatei, die die Einrichtung für Sie übernimmt. So können Sie sich auf die Entwicklung Ihrer Anwendung konzentrieren, anstatt sich mit dem Debuggen von Abhängigkeiten herumzuschlagen.
Offline-Entdecker
Wenn Sie an einer abgelegenen Forschungsstation, im Flugzeug oder in einer ländlichen Gegend mit lückenhaftem Netz arbeiten, ist die Cloud-KI nutzlos. Sobald Sie die Modellgewichte heruntergeladen haben, haben Sie einen voll funktionsfähigen Assistenten ohne Internetverbindung. Er läuft sogar im Flugzeugmodus meines Laptops ohne Verzögerungen, so dass Ihre Produktivität nicht an ein WLAN-Signal gebunden ist.
Hardware-Power-User
Wenn Sie in einen High-End-Mac oder eine NVIDIA-GPU investiert haben, liegt bei Ihnen Rechenleistung ungenutzt brach. Ollama nutzt Ihre Hardware, um Text mit einer Geschwindigkeit zu generieren, die es mit kostenpflichtigen APIs aufnehmen kann, und Ihre Hardware-Investition verwandelt sich in eine wiederkehrende Kostenersparnis. Der Nachteil ist jedoch, dass Ihr Akku leer wird und Ihre Lüfter bei intensiver Nutzung hochdrehen.
Rapid Prototyper
Der Wechsel zwischen Llama 3, Mistral und speziellen Coding-Modellen erfolgt mit einem einzigen Terminalbefehl. Sie können innerhalb von Sekunden statt Minuten testen, wie verschiedene Architekturen mit Ihren spezifischen Prompts umgehen. Das beschleunigt die Feedbackschleife bei der Auswahl des richtigen Modells für eine Nischenaufgabe.
Budgetbewusste Entwickler
Monatlich wiederkehrende Abonnements und Gebühren pro Token summieren sich, wenn Sie debuggen oder experimentieren. Lokale Inferenzen sind kostenlos, sobald Sie die Hardware besitzen, und ermöglichen unbegrenzte Iterationen ohne Rechnung. So kostet Sie das „Fail fast“-Prinzip beim Lernen kein Geld.
Preise für Ollama
Ollama arbeitet nach einem Modell, das den lokalen Entwickler gegenüber dem Cloud-Abonnenten bevorzugt. Sie laden das Framework kostenlos herunter und führen Open-Source-Modelle auf Ihrer eigenen Hardware ohne wiederkehrende monatliche Rechnungen oder Gebühren pro Token aus. Diese Vorgehensweise verlagert die finanzielle Belastung von Software-Abonnements auf Ihre Stromrechnung und GPU-Upgrades. Die Software selbst kostet zwar nichts, doch die versteckten Kosten stecken in der Hardware, die nötig ist, damit ein Modell mit 70B Parametern nicht mit drei Token pro Sekunde dahinkriecht.
Sie erhalten die CLI und die Desktop-App für macOS, Linux und Windows kostenlos. Damit entfällt die Hürde für Entwickler, die Prototypen für private Tools entwickeln und überraschende API-Rechnungen am Monatsende vermeiden möchten. Sie können unbegrenzt experimentieren, ohne dass eine Kreditkarte hinterlegt ist.
Diese kostenpflichtigen Optionen sind für Benutzer gedacht, die umfangreiche Modelle auf entfernte GPUs auslagern müssen, wenn der lokale VRAM an seine Grenzen stößt. Sie bieten eine Möglichkeit, große Reasoning-Modelle auszuführen, ohne ein dreißigtausend Dollar teures Server-Rack zu besitzen. Bei kleinen 7B-Modellen ist die lokale $0-Route jedoch fast immer die klügere Wahl. Sie zahlen nur dann, wenn Ihre lokale Hardware die benötigte Modellgröße physisch nicht bewältigen kann.
Wichtigste Funktionen von Ollama
Führen Sie Open-Source-Modelle wie Llama 3 oder Mistral direkt auf Ihrer Hardware aus
Sie senden keine privaten Codeschnipsel mehr an externe APIs und halten sensible Logik innerhalb Ihrer Firewall. Keine Datenlecks mehr während der Entwicklung.
Bündeln Sie Modellgewichte und Konfigurationen in einem einzigen „Modelfile“
Sie definieren bestimmte System-Prompts oder Parameter einmal und geben sie im gesamten Team weiter, um konsistente Ergebnisse zu erzielen. Das ist wichtig, denn es erspart Ihnen beim Prompt Engineering das leidige „Auf meinem Rechner hat es funktioniert“.
Greifen Sie auf Ihre lokalen Modelle über eine integrierte REST-API zu
Sie können Ihre benutzerdefinierten Python-Skripte oder Webanwendungen ohne komplexe Orchestrierung oder teure Token-Kosten einbinden. Sie können kostenlos Prototypen von KI-Funktionen erstellen, bevor Sie sich an einen Cloud-Anbieter binden.
Wechseln Sie zwischen verschiedenen Modellen mit einem einzigen Terminalbefehl
Der Übergang zwischen einem 7B-Parameter-Modell für den Chat und einem spezialisierten Coding-Modell erfolgt in Sekundenschnelle. Der Nachteil ist, dass größere Modelle zu langsam sind, wenn Sie keine dedizierte GPU haben. Dennoch können Sie so das richtige Tool für die jeweilige Aufgabe auswählen.
Verwalten Sie die GPU-Beschleunigung unter macOS, Linux und Windows automatisch
Ollama erkennt Ihre Hardware und verlagert so viel wie möglich auf die Grafikkarte, ohne dass Sie manuell an den Treibern herumschrauben müssen. Sie erhalten schnellere Inferenzgeschwindigkeiten, ohne zum Systemadministrator werden zu müssen.
Vor- und Nachteile von Ollama
Vorteile
Ollama reduziert die Bereitstellung lokaler Modelle auf einen einzigen Befehl. Sie ersparen sich den Albtraum der Konfiguration von CUDA-Treibern oder die Suche nach kompatiblen Binärdateien auf GitHub. Die Modelle werden vollständig auf Ihrem Rechner ausgeführt, so dass der proprietäre Code Ihr Netzwerk nie verlässt. Damit entfallen Datenschutzrisiken und die Kosten für wiederkehrende API-Abonnements. Der Wechsel zwischen Llama 3 und Mistral dauert nur Sekunden, so dass Sie ganz einfach testen können, welche Architektur Ihre spezifischen Prompts besser bewältigt. Nutzen Sie es, um KI-Anwendungen ohne Internetverbindung zu entwickeln und zu optimieren.
Nachteile
Die Hardware bleibt der ultimative Engpass. Die Ausführung eines 70B-Parameter-Modells auf einem Standard-Laptop führt zu quälend langsamen Ausgaben von einem Token pro Minute. Sie benötigen viel VRAM, um die zweistelligen Geschwindigkeiten zu erreichen, die für ein flüssiges Chaterlebnis erforderlich sind. Während Standardmodelle gut verarbeitet werden können, erfordert der Import eigener feinabgestimmter Modelle im Vergleich zu Cloud-Plattformen mehr manuellen Aufwand. Außerdem verzichten Sie auf das High-End-Reasoning riesiger Modelle wie GPT-4o, und komplexe mehrstufige Logik kann bei den kleineren Modellen, die Ihre Hardware tatsächlich unterstützen kann, versagen.
Verwenden Sie Ollama, wenn Sie wollen…
- Open-Weights-Modelle vollständig auf Ihrer eigenen Hardware ausführen.
- Sensible Daten und Prompts streng vertraulich halten.
- Wiederkehrende monatliche API-Abonnements und Nutzungsgebühren vermeiden.
- Ohne aktive Internetverbindung mit LLMs experimentieren.
- Lokale KI per API in eigene Entwicklungs-Workflows integrieren.
- Verschiedene Modellquantisierungen auf Geschwindigkeit und Genauigkeit testen.
- Cloud-Latenz vermeiden und Token sofort auf dem Gerät generieren.
- Die volle Kontrolle über Modellversionen und Deployments behalten.
Alternativen zu Ollama
Bewertungen von Ollama
Mit Ollama haben Sie zu einem Bruchteil der Kosten Zugang zu den wichtigsten Open-Source-Modellen in der Cloud, so dass Sie Modelle wie DeepSeek und Qwen problemlos testen können.
Es ist die Schicht, die es einem Dokumentarfilm-Cutter ermöglicht, Gemma auf seinem eigenen Laptop auszuführen, ohne Python-Umgebungen oder Konfigurationsdateien zu verwalten. Massive Infrastruktur für Local-First-KI.
Wir verwenden es, um LLMs lokal auszuführen, um die Iteration zu beschleunigen und Latenzzeiten zu vermeiden. Es ist, als hätten wir unser eigenes KI-Labor ohne die hohen GPU-Rechnungen.
Auf einem langen Flug konnte ich damit Produktänderungen ausprobieren, ohne auf das spärliche WLAN im Flugzeug angewiesen zu sein. Der Datenschutz ist ein großes Plus.
Sehr einfach und leistungsstark, um lokale LLMs auszuführen und anzupassen. Die Integration mit LangChain und LlamaIndex ist unkompliziert und zuverlässig.
Häufig gestellte Fragen
Benötigt Ollama eine Internetverbindung?
Sie benötigen eine Internetverbindung, um das Ollama-Installationsprogramm und die ersten Modelldateien herunterzuladen. Sobald die Modelle auf Ihrem Rechner gespeichert sind, können Sie sie vollständig offline ausführen und mit ihnen interagieren.
Wie geht Ollama mit meinen Daten um?
Ollama führt die Modelle lokal auf Ihrer Hardware aus, d. h. Ihre Prompts und die Antworten der Modelle verlassen niemals Ihren Rechner und werden nicht zur Verarbeitung an einen Cloud-Server gesendet.
Was sind die Hardwareanforderungen für die Ausführung großer Modelle?
Die Leistung der Modelle hängt stark von RAM und VRAM ab. Kleine Modelle benötigen in der Regel mindestens 8 GB RAM, während größere Modelle wie die 70B-Varianten in der Regel 32 GB oder mehr und eine kompatible GPU für akzeptable Geschwindigkeiten benötigen.
Kann ich mehrere Modelle gleichzeitig ausführen?
Ja, Ollama unterstützt das gleichzeitige Laden mehrerer Modelle, wenn Ihr System über genügend freien Arbeitsspeicher verfügt. Sie können die maximale Anzahl der geladenen Modelle mit Hilfe der Umgebungsvariablen OLLAMA_MAX_LOADED_MODELS anpassen.
Wie aktualisiere ich die Modelle, die ich heruntergeladen habe?
Sie können ein Modell auf die neueste Version aktualisieren, indem Sie den Befehl ollama pull gefolgt von dem Modellnamen ausführen. Dadurch werden alle neuen Gewichte oder Konfigurationen heruntergeladen, die in der Ollama-Bibliothek verfügbar sind.
Was ist Quantisierung und warum ist sie wichtig?
Die Quantisierung komprimiert große Modelle so, dass sie auf Consumer-Hardware passen, indem sie die Präzision ihrer Gewichte reduziert. So können Sie leistungsfähige Modelle mit weniger Arbeitsspeicher ausführen, auch wenn dies die Genauigkeit der Antworten etwas beeinträchtigen kann.
Ähnliche Tools
 Devin DesktopDevin Desktop (ehemals Windsurf) ist die agentenbasierte KI-IDE von Cognition, die ein tiefgreifendes Verständnis der Codebasis mit lokalen und Cloud-Coding-Agenten kombiniert, die
 QoderQoder ist eine agentenbasierte KI-Programmierplattform, die komplexe Arbeitsabläufe mit autonomen Agenten automatisiert und tiefe Einblicke in die Codebase gewährt.
 ReplitReplit ist eine browserbasierte IDE für die Zusammenarbeit, die über integrierte KI-Tools für nahtloses Programmieren, sofortige Bereitstellung und Echtzeit-Bearbeitung im Multiplayer-Modus verfügt.