
RunPod
Entwickler-ToolsAktualisiert am 4. Oktober 2026
RunPod ist eine skalierbare Cloud-Plattform, die GPU-Ressourcen auf Abruf sowie serverlose Endpunkte für das Training und die Inferenz von KI-Modellen bereitstellt.
Wenn Sie sich über unsere Links anmelden, erhalten wir möglicherweise eine Provision. Auf unsere Bewertungen hat das keinen Einfluss.
Was ist RunPod?
RunPod ist ein global verteilter GPU-Marktplatz, auf dem Sie High-End-Rechenleistung stundenweise mieten können, um Stable-Diffusion-Instanzen zu starten oder LLMs zu trainieren – ganz ohne den Aufwand von Unternehmens-Cloud-Verträgen. Es umgeht die Knappheit an lokaler Hardware, indem es Sie mit einem Netzwerk aus privaten Anbietern und Rechenzentrumsbetreibern verbindet, sodass Sie Docker-Container innerhalb von Sekunden auf RTX 3090s oder A100s bereitstellen können. Mir ist aufgefallen, dass die Benutzeroberfläche auf Geschwindigkeit ausgelegt ist, obwohl der Spot-Instanz-Markt bedeutet, dass Ihr Pod verschwinden könnte, wenn jemand ein höheres Gebot abgibt. Das ist wichtig, da es die Kosten für KI-Experimente im Vergleich zu Hyperscalern mit Festpreisen drastisch senkt. Nutzen Sie von der Community verwaltete Vorlagen für einen schnellen Einstieg, wechseln Sie jedoch zu dedizierten Instanzen, wenn Ihr Trainingslauf keine Unterbrechung vertragen kann.
Wie fängt man mit RunPod an?
Registrieren Sie sich zunächst in der RunPod-Konsole und verifizieren Sie Ihre E-Mail-Adresse. Sie müssen sofort Guthaben aufladen, da die Plattform ein Prepaid-Modell verwendet. Die Mindesteinzahlung ist gering, was ideal ist, um eine einzelne RTX 4090 ohne große Verpflichtung zu testen. Wenn Sie High-End-Rechenleistung stundenweise mieten, anstatt eine fünfstellige Workstation zu kaufen, sinkt die Einstiegshürde für das Training von Nischenmodellen oder die Ausführung rechenintensiver Inferenz.
Tipp: Aktivieren Sie sofort die Zwei-Faktor-Authentifizierung, um Ihr Guthaben zu schützen.Durchsuchen Sie als Nächstes die Bereiche „GPU Cloud“ oder „Serverless“, um Ihre Hardware auszuwählen. Sie können bestimmte Grafikkarten wie die A100 oder günstigere, von der Community bereitgestellte Instanzen wählen. Jeder „Pod“ erfordert eine Vorlage; die offizielle PyTorch-Vorlage eignet sich in der Regel am besten für KI-Anwendungen. Dadurch vermeiden Sie den Albtraum manueller CUDA-Treiberinstallationen. Dank vorkonfigurierter Umgebungen können Sie innerhalb von Minuten mit dem Programmieren beginnen, anstatt Kernel-Inkompatibilitäten zu beheben, allerdings können Community-Pods weniger zuverlässig sein als solche aus sicheren Rechenzentren.
Fazit: Überprüfen Sie vor der Bereitstellung die VRAM-Anforderungen, um Out-of-Memory-Fehler bei kleineren Grafikkarten zu vermeiden.Starten Sie Ihren Pod und warten Sie etwa sechzig Sekunden, bis der Container initialisiert ist. Sie können sich über ein webbasiertes Jupyter Lab verbinden oder SSH für die lokale IDE-Integration nutzen. Ich bevorzuge den SSH-Weg, da ich so VS-Code-Erweiterungen direkt auf der Remote-GPU nutzen kann. Dadurch wird ein gewöhnlicher Laptop zu einer spezialisierten KI-Maschine, die die Reaktionsgeschwindigkeit der lokalen Bearbeitung mit der rohen Rechenleistung einer Remote-H100 und einem professionellen Terminal für komplexe Skripte verbindet.
Fazit: Speichern Sie Ihren öffentlichen SSH-Schlüssel in den RunPod-Einstellungen, um bei jeder Verbindung die Passwortabfrage zu überspringen.Verwalten Sie Ihre Daten schließlich mithilfe von Netzwerkvolumes, wenn Sie Ihre Datensätze über mehrere Sitzungen hinweg behalten möchten. Der reguläre Pod-Speicher ist kurzlebig, sodass alles, was sich nicht in einem Volume befindet, verschwindet, wenn Sie die Instanz beenden. Diese Konfiguration schützt Ihre Gewichte und Protokolle auch dann, wenn Sie von einer kostengünstigen GPU zum Debuggen auf eine leistungsstarke GPU für das Training umsteigen. Für den Speicher selbst fallen geringe laufende Kosten an, doch persistente Volumes entkoppeln Ihre teure Rechenleistung von Ihren wertvollen Daten, sodass ein routinemäßiges Herunterfahren nicht Tage an Trainingsfortschritt zunichtemachen kann.
Fazit: Setzen Sie einen Pod immer auf „Stop“, um Geld zu sparen und gleichzeitig Daten zu erhalten, aber beenden Sie ihn mit „Terminate“ erst, wenn Sie vollständig fertig sind.
Für wen ist es geeignet?
Der unabhängige Forscher.
Sie benötigen High-End-NVIDIA-VRAM, um ein benutzerdefiniertes LoRA zu trainieren oder ein LLM feinabzustimmen, ohne den fünfstelligen Preis einer persönlichen Workstation zahlen zu müssen. Durch die stundenweise Anmietung einer A100 können Sie Hypothesen auf Hardware testen, die sonst unerreichbar wäre. Für Einzelexperimentatoren, die mit von Risikokapital finanzierten Labors konkurrieren, schafft das gleiche Wettbewerbsbedingungen.
Der Inferenz-Ingenieur
Sie möchten eine API für eine generative KI-App hosten, die nur dann Kosten verursacht, wenn jemand den Endpunkt tatsächlich aufruft. Serverlose GPUs starten Container bei Traffic-Spitzen und skalieren in ruhigen Zeiten wieder auf null zurück. So frisst Ihre Cloud-Rechnung nicht mehr Ihre Margen auf, während Ihre App im Leerlauf ist. Mir ist aufgefallen, dass die FlashBoot-Technologie Kaltstarts auf nur wenige Sekunden reduziert, was den Einsatz für Echtzeit-Apps machbar macht.
Der Docker-Power-User
Wenn Ihre Umgebung bereits containerisiert ist, können Sie Ihren spezifischen Stack in etwa sechzig Sekunden auf einer Remote-GPU bereitstellen. Das umgeht die „Abhängigkeitshölle“ manueller CUDA-Treiberinstallationen auf lokalen Linux-Distributionen. Sie verbringen Ihre Zeit damit, Python zu schreiben, anstatt Kernel-Inkompatibilitäten zu debuggen. Der Nachteil ist, dass Sie bei Netzwerkvolumes diszipliniert vorgehen müssen, um Daten dauerhaft zu speichern.
Der VS-Code-Entwickler
Sie bevorzugen Ihre lokale IDE, benötigen aber die rohe Rechenleistung eines entfernten H100-Clusters. Durch die Verbindung über SSH verwandelt sich Ihr Standard-Laptop in eine spezialisierte KI-Maschine mit vollem Terminalzugriff und Unterstützung für Erweiterungen. So trifft lokale Reaktionsgeschwindigkeit auf die Leistung eines Rechenzentrums. Ich habe festgestellt, dass das frühzeitige Einrichten öffentlicher SSH-Schlüssel die Unannehmlichkeiten wiederholter Passwortabfragen beseitigt.
Der Stable-Diffusion-Hobbyist
Sie möchten mit ComfyUI oder Automatic1111 ganze Stapel hochauflösender Bilder generieren, ohne Ihre Heim-GPU zu überlasten. Mit vorkonfigurierten Vorlagen können Sie innerhalb weniger Minuten eine Web-UI auf einer RTX 4090 starten. Komplexe Workflows wie ControlNet oder IP-Adapter lassen sich so deutlich schneller iterieren. Es eignet sich gut für anspruchsvolle kreative Sitzungen, ist jedoch weniger ideal für gelegentliche Prompts mit einzelnen Bildern.
Preise für RunPod
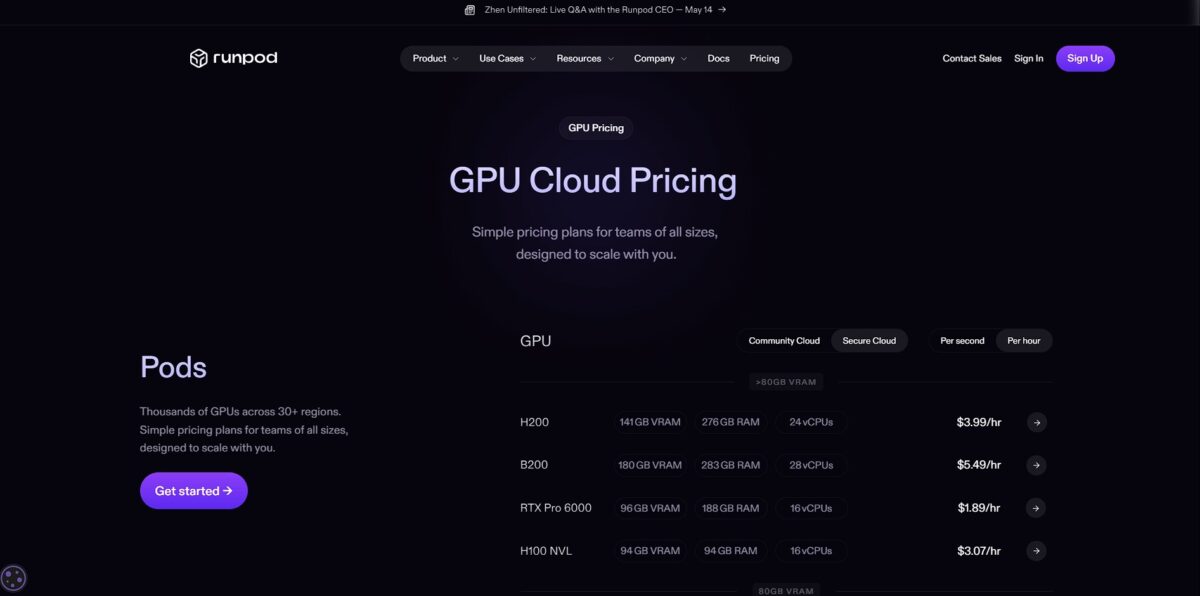
RunPod verzichtet auf das pauschale Monatsabonnement zugunsten eines marktplatzbasierten Modells, bei dem Sie GPU-Zeit sekundengenau oder stundenweise mieten. Diese Konfiguration ermöglicht Ihnen den Zugriff auf High-End-Hardware wie die H100 oder A100 ohne die hohen Aufschläge herkömmlicher Cloud-Anbieter. Sie zahlen genau das, was Sie verbrauchen, sodass ungenutzte Instanzen während langer Trainingspausen kein Geld verschlingen. Der Nachteil ist die Preisvolatilität; die Kosten schwanken je nach aktueller Netzwerknachfrage und der von Ihnen gewählten Preisstufe.
für eine RTX 4090, während die Preise bei Community-Cloud-Optionen für denselben Chip auf 0,34 $/Std. sinken können. Diese Pods stehen Ihnen zur Verfügung, bis Sie sie löschen, was Ihnen eine stabile Umgebung für komplexe Entwicklungsarbeiten bietet, ohne das Risiko einer plötzlichen Beendigung.
Sie zahlen nur, wenn Ihr Code tatsächlich läuft, was gut zu Inferenz-APIs passt, die auf null skalieren, sobald der Datenverkehr nachlässt.
Die Rechenkosten sinken zwar, der Speicher bleibt jedoch ein separater, fester Kostenfaktor. Dennoch hilft eine vorhersehbare Abrechnung Teams bei der Budgetierung für das langfristige Hosting von Modellen.
Rechnen Sie mit 0,10 $/GB/Monat für aktive Volume-Festplatten.
Ein wichtiger „Haken“ ist, dass für angehaltene Pods Speicherplatz zum doppelten Satz (0,20 $/GB/Monat) abgerechnet wird, um das Horten ungenutzter Ressourcen zu verhindern. Diese Regelung zwingt Sie zu einem disziplinierten Datenmanagement.
Wichtigste Funktionen von RunPod
Mieten Sie High-End-GPUs vom Typ NVIDIA H100 oder A100 sekundengenau
Sie vermeiden massive Investitionskosten, da Sie nur für die Rechenzyklen bezahlen, die Ihr Modelltraining tatsächlich verbraucht. Einzelforscher, die sich kein Hardware-Rack für 40.000 $ leisten können, erhalten so Zugang zur selben Hardwareklasse.
Starten Sie serverlose Endpunkte, die im Leerlauf auf null skalieren
Ihre API bleibt auch bei Traffic-Spitzen reaktionsschnell, verursacht aber keine Kosten mehr, sobald die Anfragen versiegen. Keine „Rechnungsschocks“ mehr durch ungenutzte Recheninstanzen im Rechenzentrum.
Stellen Sie benutzerdefinierte Docker-Container bereit oder nutzen Sie vorkonfigurierte Vorlagen für PyTorch und Jupyter
Sie umgehen die „Abhängigkeitshölle“ bei der Installation von CUDA-Treibern und können direkt mit Ihrem Notebook loslegen. Das verkürzt die Zeit zwischen der Idee und der Durchführung eines Benchmarks um Stunden.
Verbinden Sie persistenten Netzwerkspeicher über mehrere Pods hinweg
Ihre Trainings-Checkpoints und großen Datensätze bleiben verfügbar, selbst wenn Sie den GPU-Typ wechseln oder einen Pod neu starten. Das ist wichtig, weil es sicherstellt, dass Sie nicht Tage an Fortschritt verlieren, wenn eine Spot-Instanz freigegeben wird.
Greifen Sie auf eine Community Cloud für günstigere Tarife oder eine Secure Cloud für Compliance-Anforderungen zu
Sie wählen zwischen maximalen Einsparungen bei ungenutzter Kapazität oder dedizierter Hardware für sensible Daten. So entscheiden Sie selbst, wie Sie Preis und Datenschutz gegeneinander abwägen.
Verwenden Sie die Flash-CLI, um Python-Funktionen direkt in die Cloud zu übertragen
Sie umgehen die Notwendigkeit, Images zu erstellen und zu verwalten, indem Sie die Orchestrierung der Plattform überlassen. So können Sie sich auf die Anwendungslogik statt auf die Infrastruktur konzentrieren.
Vor- und Nachteile von RunPod
Vorteile
RunPod stellt GPUs bereit, wenn Hyperscaler „Nicht vorrätig“-Fehler anzeigen. Sie sparen sich Verkaufsgespräche und Wartezeiten bei der Kontingentfreigabe. Starten Sie eine H100 oder eine RTX 4090 in weniger als einer Minute. Die sekundengenaue Abrechnung stellt sicher, dass Sie in dem Moment aufhören zu zahlen, in dem Ihr Skript beendet ist. Die serverlosen Endpunkte skalieren auf null, wodurch Leerlaufkosten entfallen: Sie bezahlen nur für aktive Rechenleistung. Nutzen Sie die Secure Cloud für Stabilität und die Community Cloud für maximale Einsparungen.
Nachteile
Das Marktplatzmodell bringt Kompromisse bei der Stabilität mit sich. Community-Instanzen bieten massive Rabatte, sind jedoch anfällig für plötzliche Unterbrechungen. Ihr Trainingsjob könnte unterbrochen werden, wenn jemand Sie überbietet. Daher sind persistente Speichervolumes für häufige Checkpoints erforderlich. Es fehlt das umfassende Service-Ökosystem, wie es bei AWS oder Google Cloud zu finden ist. Verwaltete SQL-Datenbanken oder Unternehmensnetzwerke werden Sie hier nicht finden. Binden Sie immer ein Netzwerkvolume ein, um Ihre Daten vor dem unerwarteten Herunterfahren von Pods zu schützen.
Nutzen Sie RunPod, wenn Sie…
- High-End-GPUs für das KI-Training sekundengenau mieten.
- Serverlose Inferenz-Endpunkte ohne Infrastrukturmanagement bereitstellen.
- Sofort auf H100- oder A100-Cluster für große Modelle zugreifen.
- Persistente Pods mit vollem Root- und SSH-Zugriff ausführen.
- KI-Workloads in der Produktion mühelos weltweit skalieren.
- LLMs mithilfe kostengünstiger, von der Community bereitgestellter Rechenleistung feinabstimmen.
- GPU-Temperatur und Speicherauslastung direkt in Echtzeit überwachen.
- Komplexe Cloud-Verträge dank transparenter Abrechnung pro Sekunde vermeiden.
Alternativen zu RunPod
Bewertungen von RunPod
Hervorragend für KI-Entwicklung geeignet. Die Arbeit in einer CUDA- und GPU-unterstützten Arbeitsumgebung ist sehr wichtig, und RunPod bietet dies mit einfacher Installation.
Tolle Benutzeroberfläche und sofort verfügbare GPUs. Für einen Cloud-Hosting-Dienst der mittleren Preisklasse ist dies die beste Wahl.
Einfach zu bedienen und beste Qualität für diesen Preis. Auch der Support ist im Vergleich zu den großen Anbietern relativ unkompliziert.
Hervorragend für Startups geeignet. Es ist wirklich flexibel und einfach zu bedienen. Man kann problemlos einsatzbereite Vorlagen bereitstellen und sofort loslegen.
Häufig gestellte Fragen
Was ist der Unterschied zwischen Secure Cloud und Community Cloud?
Secure Cloud läuft in High-End-Rechenzentren mit Zuverlässigkeit und Sicherheit auf Unternehmensniveau, während Community Cloud ein Peer-to-Peer-Netzwerk aus einzelnen GPU-Anbietern nutzt. Secure Cloud eignet sich besser für Produktions-Workloads und sensible Daten, während Community Cloud deutlich günstigere Preise für unkritische Entwicklungs- und Testzwecke bietet.
Wie funktioniert persistenter Speicher?
Mit RunPod können Sie Netzwerkvolumes erstellen, die an Ihre Pods angehängt werden können. Diese Volumes stellen sicher, dass Ihre Daten, Modelle und Ihr Code auch nach der Beendigung oder dem Neustart eines Pods verfügbar bleiben, wobei Sie nur für den tatsächlich genutzten Speicherplatz bezahlen.
Was sind Spot-Instanzen?
Spot-Instanzen sind im Vergleich zu On-Demand-Preisen zu einem erheblichen Preisnachlass erhältlich. Der Nachteil ist, dass sie vorzeitig beendet werden können, wenn ein On-Demand-Nutzer die Kapazität benötigt. Daher eignen sie sich ideal für fehlertolerante Trainingsjobs, sind jedoch weniger geeignet für persistente Webdienste.
Kann ich benutzerdefinierte Docker-Images verwenden?
Ja, Sie können Pods mit beliebigen öffentlichen oder privaten Docker-Images aus Registries wie Docker Hub oder GitHub Container Registry bereitstellen. So können Sie Ihre Umgebung mit spezifischen Treibern, Bibliotheken oder Anwendungscode vorkonfigurieren.
Unterstützt RunPod serverlose Bereitstellungen?
Ja, mit RunPod Serverless können Sie KI-Modelle als Endpunkte bereitstellen, die bei Nichtnutzung auf null skalieren. Sie zahlen nur für die genaue Dauer der GPU-Rechenleistung, die zur Verarbeitung jeder Anfrage benötigt wird, was für Inferenzaufgaben mit variablem Datenverkehr äußerst kosteneffizient ist.
Wie verwalte ich Multi-GPU-Cluster?
RunPod bietet Instant Clusters an, mit denen Sie mehrere Knoten mit Hochgeschwindigkeitsverbindungen bereitstellen können. Dies ist für das verteilte Training groß angelegter Modelle konzipiert, bei denen der Speicher einer einzelnen GPU nicht ausreicht.
Ähnliche Tools
 Devin DesktopDevin Desktop (ehemals Windsurf) ist die agentenbasierte KI-IDE von Cognition, die ein tiefgreifendes Verständnis der Codebasis mit lokalen und Cloud-Coding-Agenten kombiniert, die
 QoderQoder ist eine agentenbasierte KI-Programmierplattform, die komplexe Arbeitsabläufe mit autonomen Agenten automatisiert und tiefe Einblicke in die Codebase gewährt.
 ReplitReplit ist eine browserbasierte IDE für die Zusammenarbeit, die über integrierte KI-Tools für nahtloses Programmieren, sofortige Bereitstellung und Echtzeit-Bearbeitung im Multiplayer-Modus verfügt.