
Ollama
Herramientas para desarrolladoresActualizado el 4 de octubre de 2026
Ollama es un framework de código abierto para ejecutar grandes modelos de lenguaje en local en macOS, Windows y Linux con total privacidad.
Podemos recibir una comisión si te registras a través de nuestros enlaces. Esto no influye en nuestras reseñas.
¿Qué es Ollama?
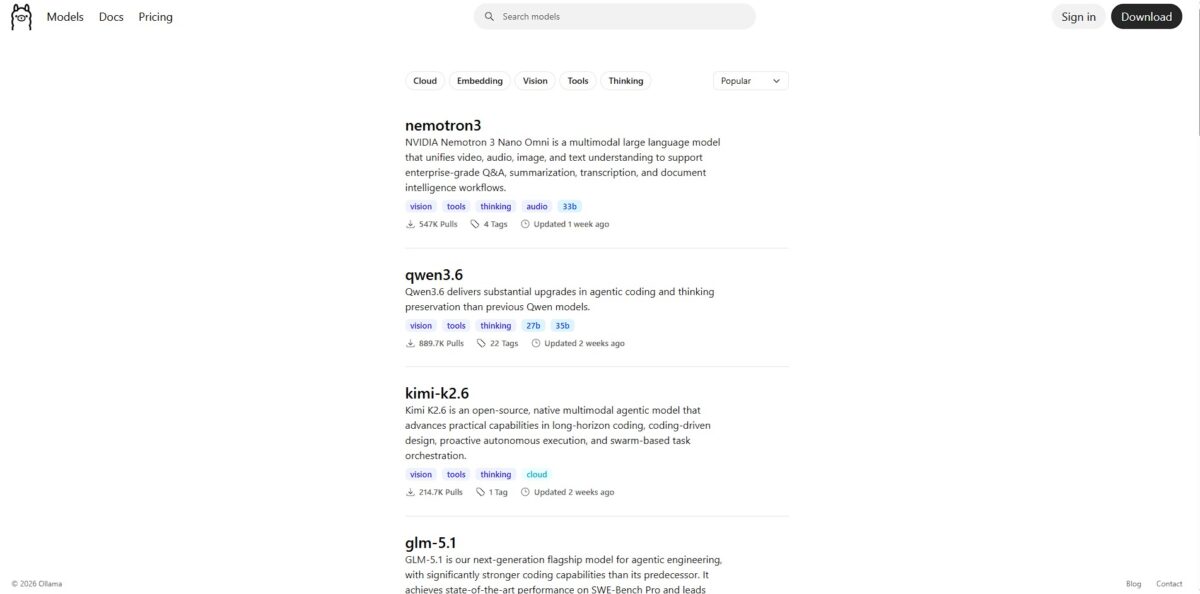
Ollama funciona como un puente ligero que saca los grandes modelos de lenguaje de la nube y los pone en tu propio hardware. Empaqueta los pesos del modelo y su configuración en un único formato portátil, lo que te permite ejecutar una instancia privada de Llama 3 o Mistral directamente desde tu terminal. Me fijé en que gestiona con inteligencia el reparto de memoria: si se llena la VRAM de tu GPU, traslada el resto a la RAM del sistema para que la generación no se caiga. Eso elimina la latencia de las llamadas de red y el coste recurrente de los tokens de API sin que tus datos salgan del dispositivo. Funciona de maravilla para construir asistentes de programación sin conexión o procesar registros sensibles, aunque el rendimiento cae bastante en equipos sin una tarjeta NVIDIA dedicada o un chip Apple Silicon. Elige Ollama si tienes al menos 16 GB de RAM y valoras la soberanía de tus datos por encima de usar los modelos más grandes disponibles.
¿Cómo empezar a usar Ollama?
Descarga el instalador para macOS o Windows desde la web oficial. En Linux tienes un script curl de una sola línea que hace todo el trabajo. La instalación en Windows crea automáticamente un servicio en segundo plano, cómodo, aunque puede sorprenderte si eres exigente con los programas de inicio. Eso pone el motor en marcha sin que toques una línea de configuración y sin la fricción de montar entornos de Python solo para hablar con una IA.
Abre tu terminal y escribe ollama run llama3.2. Si es tu primera vez, la herramienta descarga los pesos del modelo desde el registro de modelos. Verás una barra de progreso que avanza rápido con una conexión decente. Al terminar, aparece un prompt listo para tus preguntas. Es una forma rápida de probar la lógica de un modelo antes de comprometerte a construir una aplicación en torno a él.
Para una experiencia a medida, crea un Modelfile en la carpeta de tu proyecto. Puedes fijar una instrucción de sistema como “eres un desarrollador sénior de Rust” para no repetirla en cada sesión. Usa el comando ollama create my-assistant -f Modelfile para construir tu variante especializada. Eso convierte un modelo genérico en una herramienta enfocada a tu código o a tu estilo. Las instrucciones especializadas también reducen la necesidad de dar órdenes largas y repetitivas en cada conversación.
La integración suele consistir en apuntar tu IDE o tu interfaz web local a localhost:11434. La mayoría de herramientas como Cursor o AnythingLLM ya tienen un interruptor específico para Ollama. Me fijé en que, si tienes una tarjeta NVIDIA, la diferencia de velocidad frente a usar solo el procesador es abismal. Funciona bien para redactar en privado, pero cuenta con que los ventiladores se activen en las generaciones largas.
¿Para quién es?
Defensores de la privacidad
Si manejas lógica propietaria o registros de clientes, enviar datos a una API en la nube es un riesgo. Ollama mantiene cada token en tu disco local, así que tu código nunca sale de tu cortafuegos. Eso importa porque elimina el riesgo de que datos sensibles acaben en el conjunto de entrenamiento de un modelo público.
Desarrolladores alérgicos a Python
Muchas herramientas de LLM locales exigen gestionar entornos virtuales complejos o versiones concretas de CUDA. Ollama es un único ejecutable que se encarga de la instalación por ti. Puedes centrarte en construir tu aplicación en vez de depurar el infierno de dependencias.
Exploradores sin conexión
Si trabajas en una estación de investigación remota, en un avión o en una zona rural con mala cobertura, la IA en la nube no sirve. Una vez descargados los pesos, tienes un asistente plenamente funcional sin internet. Funciona incluso con mi portátil en modo avión y sin retraso alguno, así que tu productividad no depende de una señal de wifi.
Usuarios con hardware potente
Si invertiste en un Mac de gama alta o en una tarjeta NVIDIA, tienes potencia de cálculo sin aprovechar. Ollama exprime tu hardware para generar texto a velocidades que rivalizan con las API de pago, y tu inversión en hardware se convierte en un ahorro recurrente. La contrapartida es que te vaciará la batería y hará girar los ventiladores en usos intensos.
Quienes prototipan rápido
Alternar entre Llama 3, Mistral y modelos especializados en programación es cuestión de un solo comando de terminal. Puedes probar cómo tratan tus instrucciones concretas distintas arquitecturas en segundos y no en minutos. Eso acelera el ciclo de retroalimentación al elegir el modelo adecuado para una tarea de nicho.
Desarrolladores con presupuesto ajustado
Las suscripciones mensuales y las tarifas por token se acumulan cuando depuras o experimentas. La inferencia local es gratis una vez tienes el hardware y permite iteraciones infinitas sin factura. No hay fricción económica por equivocarse rápido mientras aprendes.
Precios de Ollama
Ollama funciona con un modelo que favorece a quien construye en local frente a quien se suscribe a la nube. Descargas el programa gratis y ejecutas modelos abiertos en tu propio hardware sin cuotas mensuales ni cargos por token. Ese planteamiento traslada la carga económica de las suscripciones a tu factura de la luz y a tus ampliaciones de tarjeta gráfica. Aunque el programa no cuesta nada, el peaje oculto es el hardware necesario para que un modelo de 70.000 millones de parámetros no vaya a tres tokens por segundo.
Tienes la CLI y la aplicación de escritorio para macOS, Linux y Windows sin coste. Eso elimina la barrera para quien prototipa herramientas privadas y quiere evitar facturas sorpresa de API a fin de mes. Puedes experimentar todo lo que quieras sin dar una tarjeta de crédito.
Estas opciones de pago existen para quien necesita derivar modelos enormes a GPU remotas cuando la VRAM local toca techo. Ofrece una forma de ejecutar modelos de razonamiento pesados sin tener un bastidor de servidores de treinta mil dólares. Eso sí, para modelos pequeños de 7.000 millones, la vía local gratuita casi siempre es la más inteligente. Solo pagas cuando tu hardware físicamente no puede con el tamaño de modelo que necesitas.
Características clave de Ollama
Ejecuta modelos abiertos como Llama 3 o Mistral directamente en tu hardware
Dejas de enviar fragmentos privados de código a API externas y mantienes la lógica sensible tras tu cortafuegos. Se acabaron las fugas de privacidad durante el desarrollo.
Empaqueta pesos y configuraciones del modelo en un único “Modelfile”
Defines una vez las instrucciones de sistema o los parámetros y los compartes con tu equipo para obtener resultados coherentes. Esto importa porque evita el quebradero de cabeza del “a mí me funcionaba” con las instrucciones.
Accede a tus modelos locales mediante una API REST incorporada
Puedes conectar tus scripts de Python o aplicaciones web sin orquestaciones complejas ni costes por token. Puedes prototipar funciones de IA gratis antes de comprometerte con un proveedor en la nube.
Cambia de modelo con un solo comando de terminal
Pasar de un modelo de 7.000 millones para conversar a otro especializado en programación ocurre en segundos. La contrapartida es que los modelos grandes irán muy lentos si no tienes tarjeta gráfica dedicada. Aun así, te deja elegir la herramienta adecuada para cada tarea concreta.
Gestiona automáticamente la aceleración por GPU en macOS, Linux y Windows
Ollama detecta tu hardware y deriva a la tarjeta gráfica todo lo que puede sin que toques los controladores. Consigues velocidades de inferencia mayores sin convertirte en administrador de sistemas.
Ventajas y desventajas de Ollama
Ventajas
Ollama reduce el despliegue de modelos locales a un solo comando. Te saltas la pesadilla de configurar controladores CUDA o buscar ejecutables compatibles en GitHub. Ejecuta los modelos por completo en tu máquina, así que el código propietario nunca sale de tu red. Con ello desaparecen los riesgos de privacidad y los costes recurrentes de suscripción a API. Cambiar entre Llama 3 y Mistral lleva segundos, lo que facilita probar qué arquitectura trata mejor tus instrucciones concretas. Úsalo para construir e iterar aplicaciones de IA sin conexión a internet.
Desventajas
El hardware sigue siendo el cuello de botella definitivo. Ejecutar un modelo de 70.000 millones de parámetros en un portátil normal se traduce en una lentitud dolorosa de un token por minuto. Necesitas bastante VRAM para alcanzar las velocidades de dos cifras que exige una conversación fluida. Aunque maneja bien los modelos estándar, importar modelos con fine-tuning propio requiere más trabajo manual que en las plataformas en la nube. También renuncias al razonamiento de alto nivel de modelos enormes como GPT-4o, y la lógica compleja de varios pasos puede fallar en los modelos pequeños que tu hardware sí soporta.
Usa Ollama si quieres…
- Ejecutar modelos de pesos abiertos por completo en tu propio hardware.
- Mantener estrictamente privados tus datos e instrucciones sensibles.
- Evitar suscripciones mensuales recurrentes y tarifas de uso de API.
- Experimentar con LLM sin conexión activa a internet.
- Integrar IA local en tus flujos de desarrollo mediante una API.
- Probar distintas cuantizaciones de modelo buscando velocidad y precisión.
- Eliminar la latencia de la nube y generar texto al instante en tu dispositivo.
- Mantener el control total sobre las versiones de modelo y sus despliegues.
Alternativas a Ollama
Opiniones sobre Ollama
Ollama te da acceso a los principales modelos abiertos en la nube por una fracción del coste, lo que facilita probar modelos como DeepSeek y Qwen.
Es la capa que permite a quien edita documentales ejecutar Gemma en su propio portátil sin gestionar entornos de Python ni archivos de configuración. Una infraestructura enorme para la IA que funciona primero en local.
Lo usamos para ejecutar LLM en local y así iterar más rápido y sin latencia. Es como tener nuestro propio laboratorio de IA sin las facturas enormes de GPU.
Tenerlo en un vuelo largo me permitió prototipar cambios de producto sin depender del wifi irregular del avión. La privacidad de los datos es una gran ventaja.
Muy fácil y potente para ejecutar y personalizar LLM locales. La integración con LangChain y LlamaIndex es sencilla y fiable.
Preguntas frecuentes
¿Ollama necesita conexión a internet?
Necesitas conexión para descargar el instalador de Ollama y los archivos iniciales del modelo. Una vez que los modelos están guardados en tu máquina, puedes ejecutarlos e interactuar con ellos completamente sin conexión.
¿Cómo trata Ollama la privacidad de mis datos?
Ollama ejecuta los modelos localmente en tu hardware, así que tus instrucciones y las respuestas del modelo nunca salen de tu máquina ni se envían a un servidor en la nube para procesarse.
¿Qué requisitos de hardware hacen falta para modelos grandes?
El rendimiento depende mucho de la RAM y de la VRAM. Los modelos pequeños suelen necesitar al menos 8 GB de RAM, mientras que los grandes como las variantes de 70.000 millones exigen normalmente 32 GB o más y una tarjeta gráfica compatible para alcanzar velocidades aceptables.
¿Puedo ejecutar varios modelos a la vez?
Sí, Ollama admite cargar varios modelos simultáneamente si tu sistema tiene memoria suficiente. Puedes ajustar el número máximo de modelos cargados mediante la variable de entorno OLLAMA_MAX_LOADED_MODELS.
¿Cómo actualizo los modelos que he descargado?
Puedes actualizar un modelo a su última versión ejecutando el comando ollama pull seguido del nombre del modelo. Eso traerá los pesos o configuraciones nuevas que estén disponibles en la biblioteca de Ollama.
¿Qué es la cuantización y por qué importa?
La cuantización comprime los modelos grandes para que quepan en hardware de consumo reduciendo la precisión de sus pesos. Te permite ejecutar modelos potentes con menos memoria, aunque puede afectar ligeramente a la exactitud de las respuestas.
Herramientas similares
 Devin DesktopDevin Desktop (antes Windsurf) es el IDE con agentes de IA de Cognition que combina comprensión profunda del código con agentes de
 ReplitReplit es un entorno de desarrollo colaborativo en el navegador con herramientas de IA integradas para programar sin fricciones, despliegue instantáneo y
 QoderQoder es una plataforma de programación con agentes de IA que automatiza flujos complejos con agentes autónomos y conocimiento profundo del código.