
RunPod
Herramientas para desarrolladoresActualizado el 4 de octubre de 2026
RunPod es una plataforma en la nube escalable que ofrece GPU bajo demanda y endpoints sin servidor para entrenar y ejecutar modelos de IA.
Podemos recibir una comisión si te registras a través de nuestros enlaces. Esto no influye en nuestras reseñas.
¿Qué es RunPod?
RunPod funciona como un mercado global y distribuido de GPU donde puedes alquilar potencia de cálculo avanzada por horas para lanzar instancias de Stable Diffusion o entrenar LLM, sin el engorro de los contratos de nube empresarial. Sortea la escasez de hardware local conectándote con una red de proveedores particulares y operadores de centros de datos, así que puedes desplegar contenedores de Docker en RTX 3090 o A100 en segundos. Me fijé en que la interfaz está pensada para la velocidad, aunque el mercado de instancias puntuales significa que tu instancia puede desaparecer si aparece alguien que puja más. Esto importa porque recorta drásticamente el coste de experimentar con IA frente a los grandes proveedores de precio fijo. Usa las plantillas mantenidas por la comunidad para arrancar rápido, pero pásate a instancias dedicadas si tu entrenamiento no admite interrupciones.
¿Cómo empezar a usar RunPod?
Empieza registrándote en la consola de RunPod y verificando tu correo. Tendrás que cargar saldo enseguida porque la plataforma funciona con prepago. El ingreso mínimo es bajo, ideal para probar una sola RTX 4090 sin gran compromiso. Alquilar potencia avanzada por horas en vez de comprar una estación de trabajo de cinco cifras baja la barrera de entrada para entrenar modelos de nicho o ejecutar inferencia exigente. Consejo: activa de inmediato la autenticación de dos factores para proteger tu saldo.
Después, recorre las secciones GPU Cloud o Serverless para elegir tu hardware. Puedes optar por tarjetas concretas como la A100 o por instancias más baratas aportadas por la comunidad. Cada instancia necesita una plantilla; la oficial de PyTorch suele ser la mejor para cargas de trabajo de IA. Así evitas la pesadilla de instalar a mano los controladores CUDA. La contrapartida es que las instancias de la comunidad pueden ser menos fiables que las de centros de datos seguros. Gracias a los entornos preconfigurados puedes empezar a programar en minutos en vez de resolver incompatibilidades del núcleo.
Conclusión: revisa los requisitos de VRAM antes de desplegar para evitar errores de memoria en tarjetas pequeñas.Lanza tu instancia y espera unos sesenta segundos a que el contenedor se inicialice. Puedes conectarte mediante un Jupyter Lab en el navegador o usar SSH para integrarlo con tu IDE local. Prefiero la vía SSH porque me permite usar las extensiones de VS Code directamente sobre la GPU remota. Eso convierte un portátil corriente en una máquina especializada de IA. Combinas la agilidad de la edición local con la potencia bruta de una H100 remota. El acceso por SSH ofrece una experiencia de terminal profesional para scripts complejos.
Conclusión: guarda tu clave pública SSH en los ajustes de RunPod para saltarte la petición de contraseña en cada conexión.Por último, gestiona tus datos con volúmenes de red si quieres conservar tus conjuntos de datos entre sesiones. El almacenamiento normal de la instancia es efímero, así que todo lo que no esté en un volumen desaparece al terminarla. Esa configuración protege tus pesos y registros aunque pases de una GPU barata para depurar a otra potente para entrenar. La contrapartida es un pequeño coste continuo por el propio almacenamiento. Así evitas perder días de progreso de entrenamiento por un cierre rutinario. Los volúmenes persistentes separan tu costoso cómputo de tus valiosos datos.
Conclusión: detén siempre una instancia para ahorrar dinero conservando los datos, y termínala solo cuando hayas acabado del todo.
¿Para quién es?
Investigadores independientes.
Necesitas VRAM avanzada de NVIDIA para entrenar un LoRA propio o ajustar un LLM sin pagar las cinco cifras de una estación de trabajo personal. Alquilando una A100 por horas puedes poner a prueba hipótesis con hardware que de otro modo sería inalcanzable. Eso iguala el terreno de juego para quien experimenta en solitario frente a laboratorios financiados con capital riesgo.
Ingenieros de inferencia
Quieres alojar una API para una aplicación de IA generativa que solo genere costes cuando alguien llama de verdad al endpoint. Las GPU sin servidor arrancan contenedores en los picos de tráfico y vuelven a cero en los momentos tranquilos. Así tu factura de nube deja de comerse tus márgenes mientras la aplicación está inactiva. Me fijé en que su tecnología FlashBoot reduce los arranques en frío a unos pocos segundos, lo que la hace viable para aplicaciones en tiempo real.
Usuarios avanzados de Docker
Si tu entorno ya está en contenedores, puedes desplegar tu configuración concreta en una GPU remota en unos sesenta segundos. Eso esquiva el infierno de dependencias que suponen las instalaciones manuales de controladores CUDA en distribuciones locales de Linux. Dedicas el tiempo a escribir Python en vez de a depurar incompatibilidades del núcleo. La contrapartida es que necesitas disciplina con los volúmenes de red para guardar los datos de forma permanente.
Desarrolladores de VS Code
Prefieres tu IDE local pero necesitas la potencia bruta de un clúster remoto de H100. Al conectarte por SSH, tu portátil estándar se convierte en una máquina especializada de IA con acceso completo a la terminal y soporte de extensiones. Une la agilidad local con la potencia de un centro de datos. Comprobé que configurar pronto las claves públicas SSH elimina la molestia de las peticiones repetidas de contraseña.
Aficionados a Stable Diffusion
Quieres generar tandas enteras de imágenes de alta resolución con ComfyUI o Automatic1111 sin castigar la GPU de tu casa. Con las plantillas preconfiguradas puedes lanzar una interfaz web en una RTX 4090 en pocos minutos. Los flujos complejos como ControlNet o IP-Adapter iteran mucho más rápido. Va muy bien en sesiones creativas exigentes, pero es menos idóneo para prompts ocasionales de una sola imagen.
Precios de RunPod
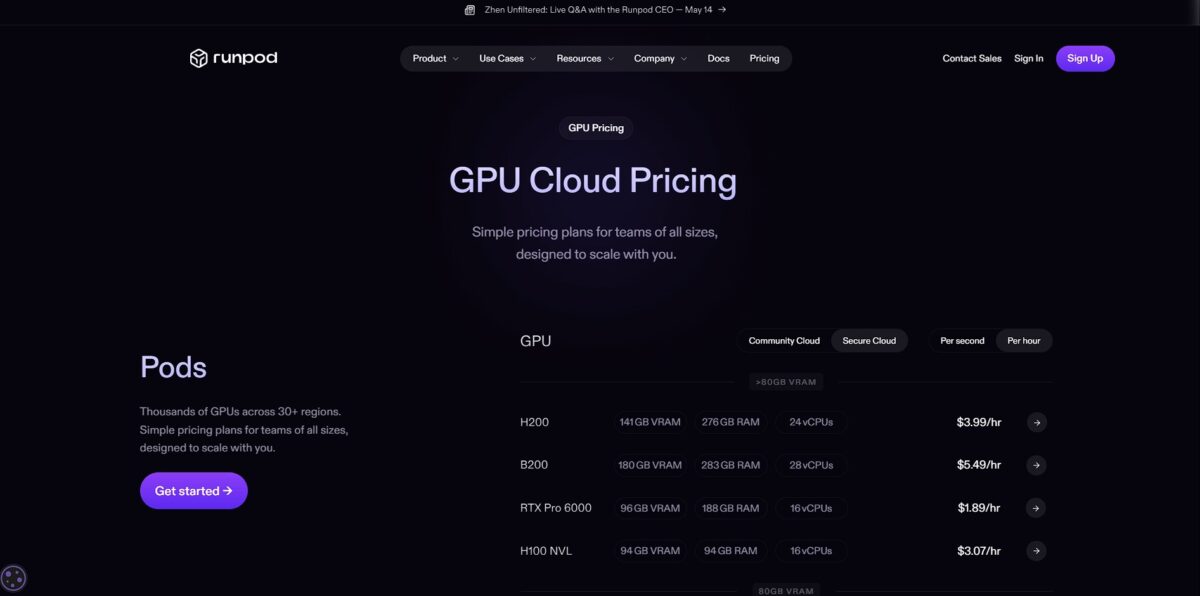
RunPod renuncia a la suscripción mensual plana en favor de un modelo de mercado donde alquilas tiempo de GPU por segundos u horas. Ese planteamiento te da acceso a hardware avanzado como la H100 o la A100 sin los grandes recargos de los proveedores de nube tradicionales. Pagas exactamente lo que consumes, así que no malgastas dinero en instancias ociosas durante las pausas largas del entrenamiento. La contrapartida es la volatilidad del precio: el coste fluctúa según la demanda de la red y el nivel de precio que elijas.
las de Secure Cloud arrancan en torno a 0,44 USD por hora para una RTX 4090, mientras que en Community Cloud el precio del mismo chip puede bajar a 0,34 USD por hora. Esas instancias siguen siendo tuyas hasta que las elimines, lo que ofrece un entorno estable para el desarrollo complejo sin riesgo de cierre repentino.
Solo pagas cuando tu código se ejecuta de verdad, lo que encaja con las API de inferencia que bajan a cero en cuanto cae el tráfico.
Aunque baja el coste de cómputo, el almacenamiento sigue siendo un coste fijo aparte. Aun así, una facturación previsible ayuda a los equipos a presupuestar el alojamiento de modelos a largo plazo.
cuenta con 0,10 USD por GB al mes en discos de volumen activos.
Un detalle importante es que las instancias detenidas facturan el almacenamiento al doble de tarifa (0,20 USD por GB al mes) para desincentivar acumular recursos sin usar. Esta política te obliga a gestionar los datos con disciplina.
Características clave de RunPod
Alquila GPU avanzadas NVIDIA H100 o A100 con facturación por segundos
Evitas grandes inversiones porque solo pagas los ciclos de cálculo que consume de verdad tu entrenamiento. Los investigadores en solitario que no pueden permitirse un bastidor de hardware de 40.000 USD acceden a la misma clase de hardware.
Lanza endpoints sin servidor que bajan a cero cuando están inactivos
Tu API sigue respondiendo en los picos de tráfico pero deja de generar costes en cuanto cesan las peticiones. Se acabaron los sustos de factura por cómputo ocioso en el centro de datos.
Despliega contenedores propios de Docker o usa plantillas preconfiguradas para PyTorch y Jupyter
Esquivas el infierno de dependencias al instalar controladores CUDA y arrancas directamente con tu notebook. Eso recorta horas entre la idea y la primera prueba comparativa.
Conecta almacenamiento de red persistente entre varias instancias
Tus checkpoints de entrenamiento y tus conjuntos de datos grandes siguen disponibles aunque cambies de tipo de GPU o reinicies una instancia. Esto importa porque garantiza que no pierdas días de progreso cuando se libera una instancia puntual.
Accede a Community Cloud con tarifas más baratas o a Secure Cloud para requisitos de cumplimiento
Eliges entre el máximo ahorro sobre capacidad ociosa o hardware dedicado para datos sensibles. Tú decides cómo equilibrar precio y privacidad.
Usa Flash CLI para enviar funciones de Python directamente a la nube
Te saltas la necesidad de construir y gestionar imágenes dejando la orquestación en manos de la plataforma. Puedes centrarte en la lógica de la aplicación en vez de en la infraestructura.
Ventajas y desventajas de RunPod
Ventajas
RunPod ofrece GPU cuando los grandes proveedores muestran errores de falta de existencias. Te ahorras las llamadas comerciales y la espera hasta que aprueben tu cuota. Lanzas una H100 o una RTX 4090 en menos de un minuto. La facturación por segundos garantiza que dejas de pagar en el instante en que termina tu script. Los endpoints sin servidor bajan a cero y eliminan los costes por inactividad: solo pagas el cómputo activo. Usa Secure Cloud para ganar estabilidad y Community Cloud para el máximo ahorro.
Desventajas
El modelo de mercado trae contrapartidas de estabilidad. Las instancias comunitarias ofrecen descuentos enormes pero son propensas a interrupciones repentinas. Tu entrenamiento puede cortarse si alguien puja más que tú, así que necesitas volúmenes persistentes para guardar checkpoints con frecuencia. Falta el ecosistema completo de servicios que se encuentra en AWS o Google Cloud. Aquí no vas a encontrar bases de datos SQL gestionadas ni redes empresariales. Monta siempre un volumen de red para proteger tus datos ante cierres inesperados de la instancia.
Usa RunPod si quieres…
- Alquilar GPU avanzadas para entrenar IA con facturación por segundos.
- Desplegar endpoints de inferencia sin servidor y sin gestionar infraestructura.
- Acceder al instante a clústeres de H100 o A100 para modelos grandes.
- Ejecutar instancias persistentes con acceso root completo y por SSH.
- Escalar sin esfuerzo cargas de IA en producción por todo el mundo.
- Ajustar LLM con potencia de cálculo barata aportada por la comunidad.
- Vigilar en tiempo real la temperatura de la GPU y el uso de memoria.
- Evitar contratos de nube complejos gracias a una facturación transparente por segundos.
Alternativas a RunPod
Opiniones sobre RunPod
Excelente para desarrollar IA. Trabajar en un entorno con soporte de CUDA y GPU es fundamental, y RunPod lo ofrece con una instalación sencilla.
Interfaz estupenda y GPU disponibles al instante. Para un servicio de alojamiento en la nube de gama media, es la mejor opción.
Fácil de usar y con la mejor calidad por este precio. El soporte también resulta relativamente sencillo comparado con los grandes proveedores.
Excelente para empresas emergentes. Es muy flexible y fácil de usar. Puedes desplegar plantillas listas para usar sin problemas y empezar de inmediato.
Preguntas frecuentes
¿Cuál es la diferencia entre Secure Cloud y Community Cloud?
Secure Cloud funciona en centros de datos de gama alta con fiabilidad y seguridad de nivel empresarial, mientras que Community Cloud usa una red entre pares de proveedores de GPU individuales. Secure Cloud encaja mejor con cargas de producción y datos sensibles, y Community Cloud ofrece precios bastante más bajos para desarrollo y pruebas no críticas.
¿Cómo funciona el almacenamiento persistente?
RunPod te permite crear volúmenes de red que se pueden conectar a tus instancias. Esos volúmenes garantizan que tus datos, modelos y código sigan disponibles aunque termines o reinicies una instancia, y solo pagas por el espacio que uses de verdad.
¿Qué son las instancias puntuales?
Las instancias puntuales están disponibles con un descuento importante frente al precio bajo demanda. La contrapartida es que pueden terminarse antes de tiempo si un usuario bajo demanda necesita esa capacidad, así que son idóneas para trabajos de entrenamiento tolerantes a fallos pero menos adecuadas para servicios web permanentes.
¿Puedo usar imágenes propias de Docker?
Sí, puedes desplegar instancias con cualquier imagen pública o privada de Docker desde registros como Docker Hub o GitHub Container Registry. Así puedes preconfigurar tu entorno con controladores, bibliotecas o código de aplicación concretos.
¿RunPod admite despliegues sin servidor?
Sí, con RunPod Serverless puedes desplegar modelos de IA como endpoints que bajan a cero cuando no se usan. Solo pagas la duración exacta del cómputo de GPU necesario para procesar cada petición, algo muy rentable en tareas de inferencia con tráfico variable.
¿Cómo gestiono clústeres con varias GPU?
RunPod ofrece Instant Clusters, que permiten desplegar varios nodos con conexiones de alta velocidad. Está pensado para el entrenamiento distribuido de modelos a gran escala, donde la memoria de una sola GPU no basta.
Herramientas similares
 Devin DesktopDevin Desktop (antes Windsurf) es el IDE con agentes de IA de Cognition que combina comprensión profunda del código con agentes de
 ReplitReplit es un entorno de desarrollo colaborativo en el navegador con herramientas de IA integradas para programar sin fricciones, despliegue instantáneo y
 QoderQoder es una plataforma de programación con agentes de IA que automatiza flujos complejos con agentes autónomos y conocimiento profundo del código.