
CometAPI
Outils de développementMis à jour le 4 octobre 2026
CometAPI est une passerelle unifiée offrant l'accès à plus de 500 modèles d'IA via un seul point d'accès API de niveau entreprise.
Nous pouvons percevoir une commission si vous vous inscrivez via nos liens. Cela n’influence pas nos avis.
Qu’est-ce que CometAPI ?
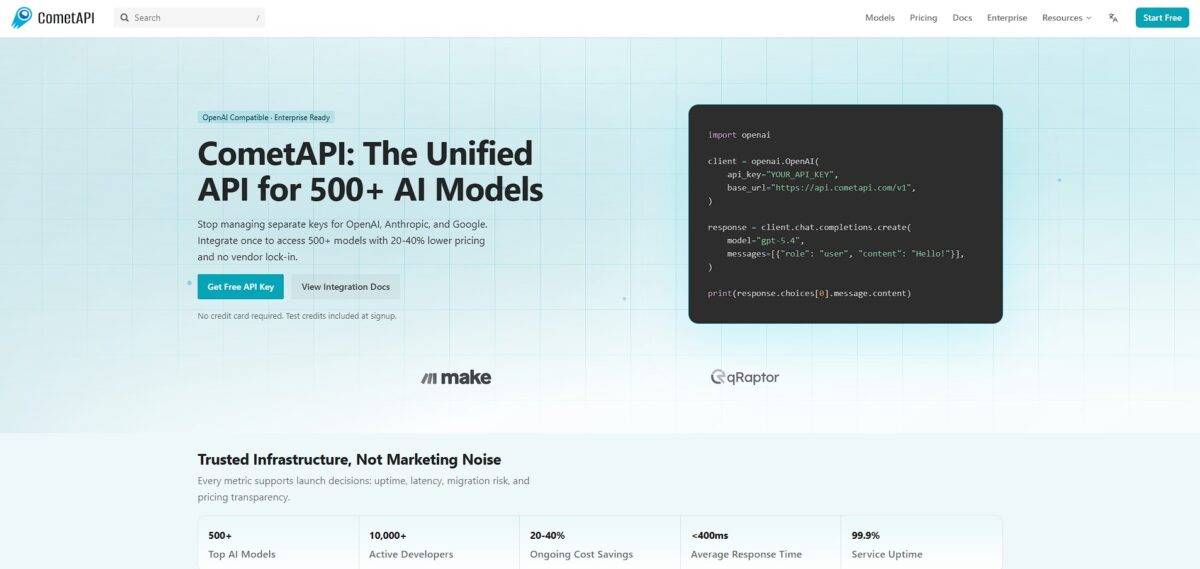
CometAPI agit comme un contrôleur de trafic unifié pour vos appels LLM, acheminant les requêtes vers divers fournisseurs via un seul point d’accès pour éviter la dépendance à un fournisseur unique. Il prend en charge le fastidieux travail de fond, du suivi de l’utilisation des tokens à la gestion de la concurrence des requêtes, afin que votre application ne s’étouffe pas lors des pics de trafic. Alors que les API de modèles individuels manquent souvent d’observabilité approfondie, cette passerelle ajoute une couche d’analyse qui révèle quels modèles épuisent réellement votre budget. J’ai remarqué qu’elle simplifie le passage d’un modèle coûteux à une alternative moins chère puisque vous ne changez qu’une seule ligne de configuration plutôt que de refactoriser toute votre logique d’authentification. C’est important, car cela garantit que votre application reste fonctionnelle même si un fournisseur spécifique subit une panne ou modifie ses limites de débit. Utilisez-la pour centraliser votre infrastructure IA, mais gardez à l’esprit que l’ajout d’une passerelle introduit un point de défaillance supplémentaire entre votre code et le modèle. Conseil pratique : commencez par y faire passer votre trafic de développement non critique pour tester la latence avant de déplacer les charges de travail de production.
Comment commencer à utiliser CometAPI ?
Commencez par créer un compte sur CometAPI. Vous vérifiez votre e-mail et accédez immédiatement au tableau de bord. L’interface est épurée et évite l’encombrement habituel des solutions d’entreprise, ce qui vous permet de vous concentrer sur la recherche du bon modèle plutôt que de lutter contre une interface utilisateur.
Accédez à la section Jeton API pour générer votre première clé. Vous cliquez sur « Ajouter un jeton » et copiez la chaîne. Elle suit généralement un format de préfixe standard. Cette clé unique remplace la douzaine d’identifiants que vous gérez habituellement pour OpenAI, Anthropic et Google, ce qui centralise votre facturation et votre sécurité en un seul endroit.
L’intégration est simple si vous utilisez le SDK OpenAI. Vous remplacez simplement le base_url par le point d’accès de CometAPI et insérez votre nouvelle clé. Pour la plupart des scripts Python, la transition est presque instantanée. Cela vous évite de réécrire la logique lors du passage de GPT-4 à Claude 3.5 Sonnet. Moins de temps sur le code répétitif, plus sur les fonctionnalités réelles.
Si vous préférez les outils low-code comme Make, recherchez le module CometAPI dans l’annuaire des applications. Vous collez votre jeton dans le champ de connexion pour autoriser les requêtes. Cela fonctionne bien pour les flux de travail automatisés comme l’analyse de sentiment sur les données de formulaires entrants. La contrepartie : une latence légèrement plus élevée qu’avec des appels API directs, mais les membres non techniques de l’équipe peuvent gérer eux-mêmes la logique IA.
Vérifiez vos indicateurs d’utilisation dans le tableau de bord après avoir exécuté quelques prompts de test. Vous pouvez voir les tokens consommés et la répartition des coûts par modèle. Cette transparence évite les factures surprises en fin de mois et vous permet d’optimiser vos dépenses en fonction de données réelles.
À qui s’adresse-t-il ?
L’architecte multi-LLM
Si vous en avez assez de suivre des clés API séparées pour OpenAI, Anthropic et Google, voici votre point d’entrée unique. Il remplace un dossier désordonné de fichiers .env par un jeton unifié. Vous passez beaucoup moins de temps sur la gestion des identifiants et la configuration répétitive.
Les fondateurs solo soucieux des coûts
Cela vous aide à trouver le chemin d’inférence le moins cher sans réécrire tout votre backend. Vous pouvez remplacer un appel GPT-4 coûteux par une instance Claude 3.5 Sonnet plus abordable en changeant une seule chaîne dans votre requête. Chaque token est optimisé, ce qui aide à préserver votre trésorerie.
L’ingénieur en fiabilité
Cela agit comme un filet de sécurité lorsqu’un fournisseur spécifique subit une panne régionale ou atteint une limite de débit. Cela maintient les applications en ligne en acheminant automatiquement le trafic vers des alternatives saines, de sorte que les erreurs « modèle indisponible » n’atteignent jamais vos utilisateurs finaux.
Les speedrunners du prototypage
Si vous devez comparer des prompts sur dix familles de modèles différentes en un après-midi, cette passerelle élimine les frictions d’intégration. Vous utilisez un SDK standard compatible OpenAI pour communiquer avec n’importe quel LLM de leur bibliothèque. Vous choisissez un gagnant en fonction des performances réelles plutôt que du battage marketing.
Les automatiseurs low-code
Cela fonctionne bien pour les équipes utilisant des outils comme Make pour créer des flux de travail IA sans personnel DevOps dédié. Vous connectez un module et accédez à plus de 500 modèles pour l’analyse de sentiment ou l’extraction de données. Attendez-vous à une latence un peu plus élevée qu’avec une connexion directe ; en contrepartie, le personnel non technique peut gérer une logique IA complexe.
Tarifs de CometAPI
CometAPI abandonne le modèle d’abonnement traditionnel pour une structure qui reflète le coût réel de l’intelligence que vous consommez. Vous payez pour ce qui transite par votre code, souvent à des tarifs inférieurs à ceux pratiqués directement par les fournisseurs principaux. Cette configuration évite le casse-tête habituel de jongler avec cinq factures de carte de crédit différentes pour cinq fournisseurs LLM différents.
Cela vous permet de tester votre logique d’intégration sur plusieurs modèles sans dépense initiale. Vous voyez comment différents modèles gèrent vos prompts spécifiques avant de vous engager sur un budget.
il n’y a pas de frais de plateforme mensuels. Vous payez pour les tokens utilisés à un tarif généralement inférieur de 20 % au tarif officiel des API. Cela aide à réduire la barrière financière lors de la montée en charge d’une surcouche ou d’un agent interne. Lors de mes tests, les économies étaient les plus visibles lors de l’acheminement de gros volumes de texte via des modèles comme Claude Sonnet, ce qui améliore directement les marges de vos fonctionnalités IA.
les grandes équipes peuvent demander une tarification personnalisée et un support dédié. Cela fonctionne bien pour les entreprises ayant besoin d’une facture unique et unifiée pour toute l’activité IA, bien que les développeurs solo trouveront plus de valeur dans les tarifs flexibles standard.
Fonctionnalités clés de CometAPI
Accédez à plus de 500 modèles d’IA via un point d’accès unique compatible OpenAI
Vous cessez de courir après la documentation de dix fournisseurs et changez simplement le nom du modèle dans votre configuration. Le temps d’intégration lors du test de nouveaux LLM passe de plusieurs jours à quelques minutes.
Redirigez les requêtes vers des fournisseurs moins chers pour des modèles courants comme GPT-4 ou Claude 3.5
Vous orientez le trafic vers des nœuds moins coûteux sans toucher à votre logique. Sur des applications de production à fort volume, cela réduit votre facture d’API mensuelle d’environ 20 %.
Absorbez de fortes charges simultanées avec un temps de réponse moyen inférieur à 400 ms
Votre application reste réactive même lors des pics qui étoufferaient les limites d’un seul fournisseur. Vos utilisateurs finaux échappent ainsi à la lassitude de l’icône de chargement qui tourne.
Basculez entre des fournisseurs comme Anthropic, Google et DeepSeek sans aucun enfermement
Si l’un tombe en panne ou change ses conditions, vous passez à un concurrent d’un clic. Votre infrastructure dispose d’un filet de sécurité qui ne dépend pas de la stabilité d’une seule entreprise.
Suivez l’usage et le coût de tous vos modèles depuis un tableau de bord unique
Vous cessez de chercher des factures dans cinq relevés de carte et voyez exactement quel modèle dévore votre budget. Les dépenses d’IA opaques deviennent des lignes prévisibles pour votre responsable financier.
Avantages et inconvénients de CometAPI
Avantages
CometAPI supprime la corvée de gérer une dizaine de comptes fournisseurs différents. Vous placez une seule clé d’API dans vos variables d’environnement et accédez immédiatement à des centaines de modèles. Cela allège votre base de code, puisque vous n’écrivez plus de logique d’intégration sur mesure pour chaque nouveau LLM. J’ai remarqué que passer de Gemini à GPT-4 prend quelques secondes au lieu d’exiger une refonte complète. C’est important, car cela évite l’enfermement chez un fournisseur et vous laisse choisir le meilleur modèle pour chaque tâche. Servez-vous-en pour tenir la disponibilité quand un fournisseur atteint ses limites de débit ou tombe en panne.
Inconvénients
La plateforme manque de transparence sur sa gestion des fonctions propres à chaque fournisseur, comme la mise en cache des entrées chez Google. Vous risquez de payer davantage sur les tâches à long contexte, faute de bénéficier des remises natives liées au cache. Le tableau de bord est fonctionnel mais dépouillé, ce qui peut agacer les utilisateurs habitués aux interfaces soignées des grands acteurs du cloud. Des utilisateurs ont rapporté que les modèles d’Anthropic paraissent plus bridés ici qu’en accès direct. Sur des prompts créatifs ou complexes, cela peut provoquer des refus inattendus. Préférez une connexion directe si votre flux de travail repose lourdement sur les économies permises par de gros caches d’entrée.
Utilisez CometAPI si vous voulez…
- Accéder à plus de 500 modèles d’IA via un point d’accès unique compatible OpenAI.
- Réduire immédiatement vos coûts d’inférence d’environ 20 %.
- Changer de fournisseur instantanément sans réécrire de code d’intégration.
- Lancer des fonctionnalités IA prêtes pour la production en moins de dix minutes.
- Éliminer le casse-tête de la gestion de dizaines de clés API.
- Faire évoluer des systèmes multi-agents avec un support de concurrence ultra élevé.
- Comparer des prompts sur plusieurs familles de modèles simultanément.
- Éviter la dépendance à un fournisseur grâce à une infrastructure agnostique.
Alternatives à CometAPI
Avis sur CometAPI
Cela m’évite de jongler avec vingt clés API différentes. Le tableau de bord unifié pour suivre les coûts entre Claude et GPT-4 est un immense soulagement pour ma comptabilité mensuelle.
La latence est étonnamment faible pour un agrégateur. J’ai basculé mon backend de production vers leur point d’accès en un après-midi sans réécrire la moindre partie de ma logique principale.
C’est excellent pour tester différents modèles côte à côte, mais les prix fluctuants peuvent être difficiles à prévoir. Idéal pour prototyper avant de s’engager avec un seul fournisseur.
L’analyse de sécurité des prompts a rassuré mon équipe. C’est même un peu moins cher que de passer directement par le fournisseur, et le vrai gain, c’est le temps économisé sur l’intégration.
Questions fréquentes
Combien de modèles d’IA sont disponibles via CometAPI ?
CometAPI donne accès à plus de 500 modèles d’IA différents, y compris des modèles populaires comme GPT-4, Claude 3.5 et Gemini 2.0, via une interface unifiée unique.
CometAPI est-il compatible avec le SDK OpenAI ?
Oui, CometAPI est entièrement compatible avec OpenAI, ce qui signifie que vous pouvez utiliser la bibliothèque officielle d’OpenAI et simplement mettre à jour l’URL de base et la clé API pour commencer à effectuer des requêtes.
CometAPI fournit-il des tokens gratuits pour les tests ?
Les nouveaux utilisateurs reçoivent généralement un million de tokens gratuits lors de l’inscription, ce qui permet une expérimentation initiale et une comparaison entre différents modèles sans coûts initiaux.
Puis-je utiliser CometAPI avec des outils d’automatisation comme Make ?
Oui, CometAPI dispose de modules dédiés pour Make qui vous permettent de créer des discussions, de lister les modèles et d’exécuter des appels API personnalisés directement dans vos scénarios automatisés.
Quelle est la latence moyenne des requêtes effectuées via CometAPI ?
La plateforme maintient un temps de réponse moyen inférieur à 400 ms, garantissant des performances à faible latence adaptées aux applications en temps réel et aux environnements de production.
La plateforme prend-elle en charge les modèles de génération d’images et de vidéos ?
Au-delà des LLM basés sur le texte, CometAPI prend en charge des modèles multimodaux pour la conversion de texte en image, d’image en texte et la génération de vidéos, tels que GPT Image et Doubao.
Outils similaires
 Devin DesktopDevin Desktop (anciennement Windsurf) est l'IDE d'IA agentique de Cognition, qui combine une compréhension approfondie de la base de code avec des
 QoderQoder est une plateforme de codage IA agentique qui automatise des workflows complexes grâce à des agents autonomes et une compréhension approfondie
 ReplitReplit est un IDE collaboratif basé sur navigateur, doté d'outils d'IA intégrés pour un codage fluide, un déploiement instantané et une édition