
MiniMax
Automatisation par l'IAMis à jour le 4 octobre 2026
MiniMax est une plateforme de développement proposant des modèles d'IA multimodaux pour le texte, la parole, la musique et la vidéo via une seule API.
Nous pouvons percevoir une commission si vous vous inscrivez via nos liens. Cela n’influence pas nos avis.
Qu’est-ce que MiniMax ?
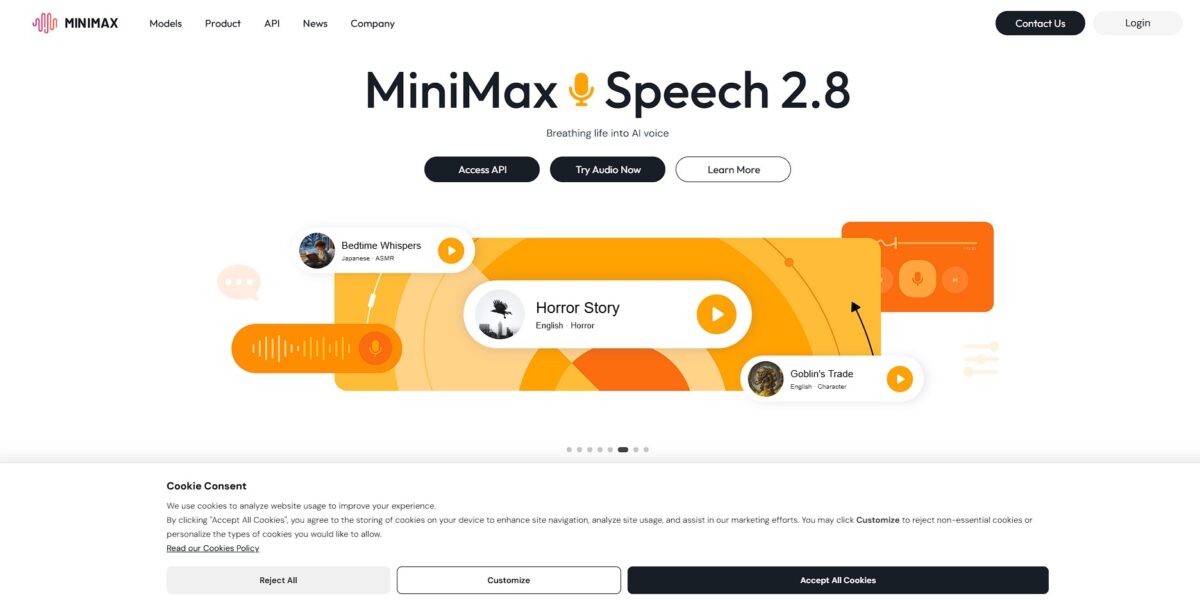
MiniMax est une plateforme axée sur les développeurs qui gère des modèles d’IA multimodaux pour le texte, la parole, la musique et la vidéo via une seule API. Elle vous donne accès à des moteurs spécialisés comme le modèle de texte M2.7 et Speech 2.8, qui gèrent tout, de l’assistance au codage complexe au clonage d’une voix humaine en environ 10 secondes. Alors que de nombreuses suites d’IA ressemblent à de simples surcouches génériques, cette plateforme est conçue pour traiter des fenêtres de contexte massives — jusqu’à 10 millions de caractères — sans la dégradation de performance habituelle. J’ai remarqué qu’elle gère bien mieux le texte désordonné et non standard comme les numéros de téléphone ou les URL que les outils de synthèse vocale traditionnels, en les lisant naturellement plutôt que caractère par caractère. C’est important, car cela vous évite d’écrire des scripts de prétraitement personnalisés pour chaque champ de données dynamique de votre application. Elle convient parfaitement pour créer des agents vocaux réactifs ou des flux de travail d’automatisation, bien que le système de crédits puisse être limité si vous ne faites que tester. Si vous avez besoin de voix de personnages cohérentes ou d’une analyse de documents complexes sur plusieurs formats, c’est une alternative technique solide aux fournisseurs de LLM classiques. Utilisez-la lorsque la faible latence audio ou la gestion de contexte massif priment sur une simple logique de chatbot.
Comment commencer à utiliser MiniMax ?
Commencez sur platform.minimax.io pour configurer votre compte développeur. Vous aurez besoin d’un e-mail valide pour passer la première étape. Une fois à l’intérieur, accédez à la section Clés API pour générer votre premier secret. Cette clé identifie vos requêtes et suit votre utilisation. Copiez-la immédiatement et stockez-la dans un fichier d’environnement sécurisé, car le tableau de bord la masque après l’affichage initial. Cela évite une exposition accidentelle dans des dépôts publics.
Ensuite, choisissez entre le modèle de paiement à l’usage et un Token Plan spécifique. Le premier gère des charges de travail variées à travers le texte, la vidéo et l’audio, tandis que des plans comme Starter ou Pro offrent des quotas mensuels fixes. Vous devrez recharger votre solde dans la section facturation avant que l’API n’accepte les appels. Un solde suffisant garantit que vos scripts de production ne tombent pas en panne par manque de fonds. Ceci est crucial pour maintenir la disponibilité dans les applications en production.
L’intégration est simple car MiniMax utilise un format compatible avec OpenAI. Vous pouvez utiliser le SDK OpenAI standard en pointant simplement l’URL de base vers https://api.minimax.io/v1. Ce simple changement vous permet de réutiliser la logique existante pour les complétions de chat ou le clonage vocal sans refonte complète. La plateforme prend également en charge un point de terminaison compatible avec Anthropic si vous préférez cette structure. Des options de SDK flexibles signifient que vous passez moins de temps à déboguer du code répétitif et plus de temps à tester les réponses du modèle.
Avant de passer à l’échelle, exécutez un appel de test avec un modèle comme m2.5 pour vérifier vos identifiants. Une simple commande curl ou un court script Python confirmera que votre clé est active. Consultez le playground de modèle pour ajuster visuellement des paramètres comme la température et le nombre maximal de jetons. Cet environnement vous aide à trouver le bon équilibre entre sortie créative et réponses prévisibles. Affiner ces réglages tôt évite de gaspiller des crédits sur des générations inutilisables.
Exportez votre clé API en tant que variable d’environnement pour la garder hors de votre code source.
À qui s’adresse-t-il ?
Développeurs indépendants
Vous disposez d’un véritable service de doublage sans la masse salariale. C’est parfait pour peupler un RPG de voix de PNJ distinctes, bien que vous passiez du temps à ajuster les prompts pour obtenir le rendu émotionnel juste. Les mondes de jeu qui resteraient autrement silencieux gagnent une vraie profondeur.
Créateurs de contenu multilingue
Une vidéo devient dix. Vous pouvez cloner votre propre voix pour parler trente langues tout en conservant vos intonations et votre rythme spécifiques. L’identité de votre marque franchit ainsi les frontières sans embaucher de traducteurs ou de doubleurs.
Concepteurs d’e-learning
Les modules techniques nécessitent souvent une narration sèche et claire qui reste cohérente à travers des dizaines de mises à jour. Vous pouvez remplacer un paragraphe dans un cours vieux de six mois et le nouvel audio ne sonnera pas comme une personne différente. Les étudiants ne sont pas distraits par des changements audio brusques.
Créateurs d’applications vidéo IA
Les développeurs peuvent utiliser l’API pour intégrer la génération vocale en temps réel ou la synchronisation labiale directement dans leur propre logiciel. Elle gère le gros du travail d’alignement audio-vidéo pour que vous n’ayez pas à construire des modèles personnalisés à partir de zéro. Pour les applications multimodales, cela réduit drastiquement le temps de développement.
Marketeurs sur les réseaux sociaux
Créer des publicités express avec des accroches émotionnelles devient une tâche de dix minutes. Vous pouvez tester cinq tons vocaux différents — de l’énergique au sérieux — sur le même script pour voir ce qui convertit. Vous obtenez ainsi des tests A/B rapides de l’impact audio sans sessions de réenregistrement.
Ingénieurs en accessibilité
Elle offre un moyen de transformer du texte statique en parole au rendu naturel pour les utilisateurs qui dépendent de la navigation audio. Alors que les lecteurs d’écran standards sont fonctionnels, ces modèles offrent une cadence plus humaine pour la lecture longue. Pour les utilisateurs malvoyants, cela signifie moins de fatigue d’écoute.
Tarifs de MiniMax
MiniMax cible le développeur soucieux des coûts qui a besoin de modèles axés sur la logique sans les tarifs de la Silicon Valley. Sa grille tarifaire privilégie le pragmatisme et répartit les coûts entre les jetons d’API bruts et des plans d’abonnement dédiés pour des médias spécifiques comme la voix ou la vidéo.
La facturation API pour le modèle phare M2.7 suit un format strict de paiement à l’usage. Vous payez 0,30 $ par million de jetons en entrée et 1,20 $ par million de jetons en sortie. Cela aide lors de l’exécution de traitements par lots à volume élevé pour la documentation ou les migrations de bases de code. Pour les développeurs utilisant Claude Code ou Cursor, le Token Plan offre un portefeuille unifié pour toutes les modalités. Si vous avez besoin d’une vitesse dédiée, les plans Highspeed commencent à 400 $ par an pour 4 500 requêtes toutes les cinq heures. J’ai remarqué que, si les jetons de texte sont bon marché, la tarification par paliers pour les images et le clonage vocal peut s’accumuler si vous ne surveillez pas votre utilisation quotidienne de caractères.
En résumé : des coûts de jetons bas vous permettent d’exécuter des agents de raisonnement complexes pour une fraction du prix des modèles de pointe occidentaux.
Fonctionnalités clés de MiniMax
L’auto-optimisation récursive laisse le modèle repérer ses propres trous de logique et produire des données synthétiques pour les combler. Ce cycle fait passer l’entraînement d’un événement figé, mené par des humains, à une boucle autonome qui affine les performances sans attendre une grande mise à jour. En pratique, le modèle s’adapte aux cas limites complexes plus vite que les cycles de publication classiques ne le permettent.
L’architecture Mixture of Experts (MoE) n’active que 10 milliards de paramètres sur un total de 230 milliards pour chaque jeton traité. Vous obtenez la profondeur de raisonnement d’un modèle massif tout en gardant des coûts d’inférence et une latence proches d’un outil léger. Vous pouvez ainsi faire tourner des chaînes d’agents denses en plusieurs étapes sans faire exploser votre budget ni attendre des réponses lentes.
Des mécanismes d’attention hybrides combinent l’attention linéaire Lightning pour le contexte lointain et un softmax classique pour la précision locale. Le modèle garde le cap sur des détails précis même quand vous lui donnez une base de code de 200 000 jetons ou un long document juridique. Cela évite le problème du « perdu au milieu », où les LLM ignorent des données enfouies dans de longs prompts.
La prise en charge native des « équipes d’agents » laisse le modèle ancrer différentes identités de rôle et gérer un raisonnement contradictoire entre sous-agents. Il assure la différenciation des comportements en interne au lieu de s’appuyer sur de fragiles prompts système pour empêcher les agents de se répéter. Bâtir des chaînes d’automatisation complexes à plusieurs rôles demande ainsi moins de gestion.
Le raisonnement entrelacé enveloppe les traces internes dans des balises précises afin de préserver la logique lors d’un débogage sur plusieurs tours. En gardant le « fil de pensée » dans l’historique, le modèle ne perd pas le contexte quand vous lui demandez de corriger un bogue qu’il vient d’analyser. Les corrections de suivi deviennent nettement plus justes, car le modèle « se souvient » de son raisonnement antérieur.
Une matrice de modèles multimodaux réunit texte, clonage vocal ultra-réaliste et génération vidéo sous une même plateforme de développement. Vous pouvez bâtir un agent qui analyse un tableur puis produit aussitôt un résumé vidéo commenté ou une piste musicale pour une présentation. Vous n’avez plus à assembler cinq API venues de cinq fournisseurs différents.
Une optimisation poussée pour la bureautique permet une édition fidèle des formules Excel, des mises en page PPT et de la structure d’un document Word. Le modèle comprend l’environnement d’un tableur, ce qui lui permet de raisonner sur les causes d’indicateurs de surveillance ou de problèmes de base de données. L’IA cesse d’être une simple rédactrice de texte pour devenir une travailleuse numérique qui manipule réellement des fichiers.
Avantages et inconvénients de MiniMax
Avantages
MiniMax touche un point d’équilibre pour les développeurs qui veulent itérer vite sans vider leur budget. Le modèle M2.5 tourne à 100 jetons par seconde, ce qui vous fait passer moins de temps à regarder un curseur clignoter et plus de temps à relire la logique. J’ai remarqué qu’il gère les modifications multi-fichiers et les boucles pilotées par les tests avec une justesse surprenante, repérant souvent ses propres erreurs avant vous. Il fait un bon coéquipier de corvée, capable de mouliner le débogage répétitif et le code passe-partout. Des heures de code manuel se réduisent à quelques minutes d’automatisation supervisée. Si vous devez construire des applications fonctionnelles ou une logique backend complexe avec un budget serré, c’est un choix de premier plan.
Inconvénients
La plateforme n’est pas sans frictions, notamment à cause de son système de crédits restrictif et de ses trous de logique occasionnels. Les limites de crédits quotidiennes paraissent souvent étouffantes, et le système se dérègle parfois en vous bloquant juste au moment de finir une tâche. S’il excelle dans l’exécution directe, il peine sur le raisonnement abstrait ou les architectures très complexes, où il peut halluciner, voire « pulvériser » une base de code si on lui laisse trop d’autonomie. Le passage de modèles à poids ouverts à des modèles propriétaires comme M2.7 a aussi laissé la communauté de développeurs avec un sentiment de perte de contrôle. C’est important, car des crédits peu fiables et des hallucinations trop assurées peuvent faire dérailler une chaîne de production. Utilisez-le pour des tâches tactiques, mais gardez un humain dans la boucle pour les décisions d’architecture.
Utilisez MiniMax si vous voulez…
- Créer des agents autonomes dotés d’une précision de codage d’élite.
- Intégrer des modèles de texte, de voix et de vidéo hautement performants.
- Exploiter un raisonnement multilingue de pointe pour des applications mondiales.
- Maximiser la vitesse d’inférence avec une API native ultra-rapide.
- Déployer des LLM rentables qui rivalisent avec les leaders phares du secteur.
- Automatiser des flux de travail bureautiques complexes avec une précision professionnelle.
- Créer des clones vocaux réalistes pour des expériences utilisateur immersives.
- Faire évoluer l’IA en production sans dépasser votre budget de développement.
Alternatives à MiniMax

Avis sur MiniMax
M2.5 est un vrai concurrent de Claude. L’« Architect Mindset » fonctionne vraiment pour les refactorisations complexes, et le prix est imbattable pour le niveau d’intelligence obtenu.
Speech 2.8 est la synthèse vocale la plus naturelle que j’aie utilisée. Pouvoir insérer des pauses et des émotions phrase par phrase change vraiment la donne pour mes flux de travail vidéo.
Physique impressionnante dans le générateur vidéo. Les objets se déplacent avec un vrai poids et une vraie inertie, même s’il a encore un peu de mal à animer des humains à partir de photos de stock.
L’agent de recherche dans M1 est de premier ordre. Il comprend la pertinence temporelle et ne reste pas bloqué sur des données obsolètes de 2023 comme la plupart des autres modèles que j’ai testés.
J’ai créé un site e-commerce full-stack à partir d’un seul prompt en utilisant l’Agent MiniMax. Les outils no-code sont généralement limités, mais celui-ci a produit un code propre et fonctionnel.
Questions fréquentes
Quelles modalités MiniMax prend-il en charge ?
MiniMax propose une suite complète de modèles de fondation couvrant cinq domaines majeurs : texte, parole, vidéo, image et musique, prenant en charge diverses applications créatives et techniques.
Quel modèle est recommandé pour les tâches de codage IA ?
Les modèles MiniMax M2.7 et M2.1 sont spécifiquement conçus pour les tâches de codage avancées et agentiques, offrant de solides performances dans les modifications multi-fichiers et les réparations validées par des tests.
Les modèles MiniMax sont-ils compatibles avec les SDK existants pour développeurs ?
Oui, les modèles MiniMax sont compatibles avec les SDK Anthropic et OpenAI, permettant aux développeurs de les intégrer facilement dans leurs flux de travail existants à l’aide d’outils familiers.
MiniMax propose-t-il une synthèse vocale en temps réel ?
Oui, MiniMax Speech 2.8 Turbo offre une synthèse vocale haute définition avec une latence de traitement inférieure à 250 millisecondes, adaptée aux applications interactives et à la diffusion en direct.
Puis-je créer des voix personnalisées avec MiniMax ?
Oui, la plateforme inclut une fonctionnalité de clonage vocal (Voice Clone) qui permet aux utilisateurs d’extraire les caractéristiques de timbre d’un audio de référence pour créer des modèles vocaux personnalisés et cohérents.
Quelles sont les limites d’utilisation pour le niveau gratuit destiné aux développeurs ?
Le niveau gratuit inclut généralement 5 $ de crédits mensuels, avec des limites de débit de 1 000 requêtes par jour et 100 requêtes par minute, ainsi qu’un plafond sur la génération vidéo mensuelle.
En quoi les clés du Coding Plan diffèrent-elles des clés API générales ?
Les clés du Coding Plan sont conçues pour les tâches de codage et agentiques à haute fréquence avec une tarification d’abonnement prévisible, tandis que les clés API générales offrent un accès flexible avec paiement au jeton pour diverses utilisations de modèles.
MiniMax prend-il en charge les tâches complexes de logiciels bureautiques ?
Oui, le modèle M2.7 est optimisé pour les scénarios bureautiques professionnels, capable de gérer des éditions complexes et des révisions multi-tours dans les fichiers Excel, Word et PPT.
Outils similaires
 PipedreamPipedream est une plateforme d'intégration conçue avant tout pour les développeurs, qui permet de connecter plus de 3 000 API avec du
 AntiGravity (Google)AntiGravity est un IDE agentique de Google conçu pour le codage autonome, l'orchestration de tâches et la synchronisation transparente des développeurs entre
 JoyLinkJoyLink est un outil d'automatisation d'affiliation Amazon qui augmente les conversions grâce à des liens profonds intelligents et une détection des offres