
Ollama
Outils de développementMis à jour le 4 octobre 2026
Ollama est un framework open-source permettant d'exécuter des grands modèles de langage localement sur macOS, Windows et Linux, avec une confidentialité totale.
Nous pouvons percevoir une commission si vous vous inscrivez via nos liens. Cela n’influence pas nos avis.
Qu’est-ce qu’Ollama ?
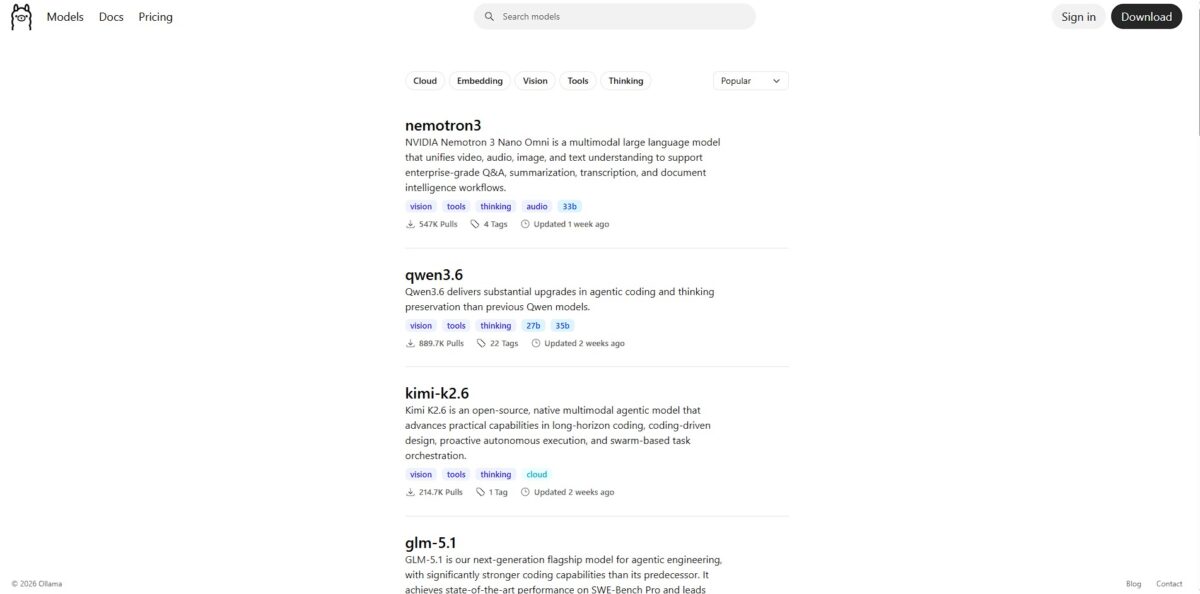
Ollama fonctionne comme un pont léger qui extrait les grands modèles de langage du cloud pour les faire fonctionner sur votre propre matériel. Il regroupe les poids du modèle et les configurations dans un format unique et portable, vous permettant d’exécuter une instance privée de Llama 3 ou Mistral directement depuis votre terminal. J’ai remarqué qu’il gère intelligemment le déchargement de la mémoire ; si la VRAM de votre GPU se remplit, il transfère le reste vers la RAM système pour éviter que la génération ne plante. Cela élimine la latence des appels réseau et le coût récurrent des jetons d’API tout en gardant vos données strictement sur l’appareil. Cela fonctionne parfaitement pour créer des assistants de codage hors ligne ou traiter des journaux sensibles, bien que les performances chutent significativement sur les machines sans puce NVIDIA ou Apple Silicon dédiée. Choisissez Ollama si vous disposez d’au moins 16 Go de RAM et que vous valorisez la souveraineté des données plutôt que l’utilisation des plus grands modèles disponibles.
Comment commencer à utiliser Ollama ?
Téléchargez le programme d’installation pour macOS ou Windows depuis le site officiel. Les utilisateurs de Linux disposent d’un script curl en une ligne qui fait tout le travail. L’installation sous Windows configure automatiquement un service en arrière-plan, ce qui est pratique mais peut vous surprendre si vous êtes pointilleux sur les applications au démarrage. Cela permet de faire fonctionner le moteur sans toucher une seule ligne de code de configuration, et sans la friction de la configuration d’environnements Python juste pour communiquer avec une IA.
Ouvrez votre terminal et tapez ollama run llama3.2. Lors de la première utilisation, l’outil récupère les poids du modèle depuis le registre. Vous verrez une barre de progression qui avance réellement vite sur une bonne connexion. Une fois terminé, vous obtenez une invite en chevron prête pour vos questions. C’est un moyen rapide de tester la logique d’un modèle avant de vous engager à construire une application autour de celui-ci.
Pour une expérience personnalisée, créez un Modelfile dans votre dossier de projet. Vous pouvez intégrer un prompt système comme « Vous êtes un développeur Rust senior » afin de ne pas vous répéter à chaque session. Utilisez la commande ollama create my-assistant -f Modelfile pour créer votre variante spécialisée. Cela transforme un modèle générique en un outil ciblé, adapté à votre base de code ou à votre style spécifique. Des prompts spécialisés réduisent aussi le besoin d’instructions longues et répétitives dans chaque discussion.
L’intégration implique généralement de pointer votre IDE ou votre interface web locale vers localhost:11434. La plupart des outils comme Cursor ou AnythingLLM proposent désormais une option dédiée à Ollama. J’ai remarqué que si vous avez un GPU NVIDIA, la différence de vitesse avec l’inférence sur CPU seul est flagrante. Cela fonctionne bien pour la rédaction privée, mais attendez-vous à ce que vos ventilateurs s’emballent pendant les longues tâches de génération.
À qui s’adresse-t-il ?
Le défenseur de la vie privée
Si vous manipulez une logique propriétaire ou des journaux clients, envoyer des données à une API cloud représente un risque. Ollama conserve chaque jeton sur votre disque local, de sorte que votre code ne quitte jamais votre pare-feu. C’est important, car cela élimine le risque que des données sensibles se retrouvent dans l’ensemble d’entraînement d’un modèle public.
Le développeur allergique à Python
De nombreux outils de LLM locaux nécessitent de gérer des environnements virtuels complexes ou des versions spécifiques de CUDA. Ollama est un binaire unique qui gère la configuration pour vous. Vous pouvez vous concentrer sur la construction de votre application plutôt que de déboguer l’enfer des dépendances.
Les explorateurs hors ligne
Si vous travaillez depuis une station de recherche isolée, un avion, ou une zone rurale avec une connexion capricieuse, l’IA cloud est inutile. Une fois les poids du modèle téléchargés, vous disposez d’un assistant entièrement fonctionnel sans connexion internet. Il fonctionne même en mode avion sur mon ordinateur portable sans aucun décalage, de sorte que votre productivité n’est pas liée à un signal Wi-Fi.
Les utilisateurs de matériel puissant
Si vous avez investi dans un Mac haut de gamme ou un GPU NVIDIA, vous disposez d’une puissance de calcul inexploitée. Ollama exploite votre matériel pour générer du texte à des vitesses rivalisant avec les API payantes, et votre investissement matériel se transforme en économie récurrente. La contrepartie : il videra votre batterie et fera tourner vos ventilateurs lors d’une utilisation intensive.
Les prototypeurs rapides
Basculer entre Llama 3, Mistral et des modèles de codage spécialisés se fait avec une seule commande de terminal. Vous pouvez tester comment différentes architectures gèrent vos prompts en quelques secondes plutôt qu’en minutes. Cela accélère la boucle de rétroaction lors du choix du bon modèle pour une tâche de niche.
Les créateurs soucieux du budget
Les abonnements mensuels récurrents et les frais par jeton s’accumulent lorsque vous déboguez ou expérimentez. L’inférence locale est gratuite une fois que vous possédez le matériel, permettant des itérations infinies sans facture. Il n’y a aucune friction financière liée à l’apprentissage par « échec rapide ».
Tarifs d’Ollama
Ollama fonctionne selon un modèle qui favorise le créateur local plutôt que l’abonné au cloud. Vous téléchargez gratuitement le framework et exécutez des modèles open-source sur votre propre matériel sans factures mensuelles récurrentes ni frais par jeton. Ce fonctionnement transfère le fardeau financier des abonnements logiciels vers votre facture d’électricité et vos mises à niveau de GPU. Bien que le logiciel lui-même soit gratuit, le coût caché est le matériel nécessaire pour empêcher un modèle à 70 milliards de paramètres de se traîner à trois jetons par seconde.
Vous obtenez le CLI et l’application de bureau pour macOS, Linux et Windows gratuitement. Cela supprime la barrière pour les développeurs prototypant des outils privés qui veulent éviter des factures d’API surprises en fin de mois. Vous pouvez expérimenter autant que vous le souhaitez sans carte de crédit enregistrée.
Ces options payantes existent pour les utilisateurs qui doivent décharger des modèles massifs vers des GPU distants lorsque la VRAM locale atteint un plafond strict. Cela offre un moyen d’exécuter des modèles de raisonnement lourds sans posséder un rack de serveurs à trente mille dollars. Pour les petits modèles 7B, toutefois, la voie locale à 0 $ est presque toujours le choix le plus judicieux. Vous ne payez que lorsque votre matériel local ne peut physiquement pas gérer la taille de modèle dont vous avez besoin.
Fonctionnalités clés d’Ollama
Faites tourner des modèles open-source comme Llama 3 ou Mistral directement sur votre matériel
Vous cessez d’envoyer des bouts de code confidentiels à des API externes et gardez la logique sensible derrière votre pare-feu. Fini les fuites de données pendant le développement.
Regroupez poids de modèle et réglages dans un unique « Modelfile »
Vous définissez une fois vos prompts système ou vos paramètres, puis vous les partagez avec l’équipe pour des résultats homogènes. C’est important, car cela évite le casse-tête du « ça marchait sur ma machine » appliqué aux prompts.
Accédez à vos modèles locaux via une API REST intégrée
Vous pouvez brancher vos scripts Python personnalisés ou vos applications web sans orchestration compliquée ni coûts de jetons élevés. Vous pouvez prototyper gratuitement des fonctions d’IA avant de vous engager chez un fournisseur cloud.
Passez d’un modèle à l’autre avec une seule commande dans le terminal
Le passage d’un modèle 7B pour la conversation à un modèle spécialisé en code se fait en quelques secondes. En contrepartie, les gros modèles avancent au ralenti sans GPU dédié. Cela vous permet tout de même de choisir l’outil adapté à la tâche du moment.
Gérez automatiquement l’accélération GPU sous macOS, Linux et Windows
Ollama détecte votre matériel et délègue le maximum à la carte graphique, sans bricolage de pilotes. Vous gagnez en vitesse d’inférence sans devenir administrateur système.
Avantages et inconvénients d’Ollama
Avantages
Ollama ramène le déploiement local d’un modèle à une seule commande. Vous échappez au cauchemar de la configuration des pilotes CUDA ou de la chasse aux binaires compatibles sur GitHub. Il exécute les modèles entièrement sur votre machine, si bien que le code propriétaire ne quitte jamais votre réseau. Les risques pour la confidentialité des données et les coûts récurrents d’abonnement à l’API disparaissent du même coup. Passer de Llama 3 à Mistral prend quelques secondes, ce qui facilite l’essai de l’architecture qui traite le mieux vos prompts. Utilisez-le pour construire et itérer sur des applications d’IA sans connexion internet.
Inconvénients
Le matériel reste le goulot d’étranglement ultime. Faire tourner un modèle à 70 milliards de paramètres sur un portable ordinaire donne un pénible rythme d’un jeton par minute. Il vous faut beaucoup de VRAM pour atteindre les vitesses à deux chiffres qu’exige une conversation fluide. S’il gère bien les modèles courants, les modèles affinés personnalisés (fine-tunes) demandent plus de travail manuel à importer que sur les plateformes cloud. La contrepartie est un raisonnement moins poussé qu’avec des modèles massifs comme GPT-4o, et une logique complexe en plusieurs étapes peut échouer sur les modèles plus petits que votre matériel accepte réellement.
Utilisez Ollama si vous voulez…
- Exécuter des modèles à poids ouverts entièrement sur votre propre matériel.
- Garder vos données sensibles et vos prompts strictement confidentiels.
- Éviter les abonnements API mensuels récurrents et les frais d’utilisation.
- Expérimenter avec des LLM sans connexion internet active.
- Intégrer l’IA locale dans des workflows de développement personnalisés via API.
- Tester différentes quantifications de modèles pour la vitesse et la précision.
- Éliminer la latence du cloud pour une génération de jetons immédiate sur l’appareil.
- Garder le contrôle total sur les versions de modèles et les déploiements.
Alternatives à Ollama
Avis sur Ollama
Ollama vous donne accès aux principaux modèles open source sur le cloud pour une fraction du coût, ce qui facilite le test de modèles comme DeepSeek et Qwen.
C’est la couche qui permet à un monteur de documentaires d’exécuter Gemma sur son propre ordinateur portable sans gérer d’environnements Python ou de fichiers de configuration. Une infrastructure massive pour l’IA locale.
Nous l’utilisons pour exécuter des LLM localement afin d’obtenir une itération plus rapide et une latence nulle. C’est comme avoir notre propre laboratoire d’IA sans les factures massives de GPU.
L’avoir lors d’un long vol m’a aidé à prototyper des changements de produit sans dépendre d’un wifi d’avion capricieux. La confidentialité des données est un énorme avantage.
Très facile et puissant pour exécuter et personnaliser des LLM locaux. L’intégration avec LangChain et LlamaIndex est simple et fiable.
Questions fréquentes
Ollama nécessite-t-il une connexion internet ?
Vous avez besoin d’une connexion internet pour télécharger le programme d’installation d’Ollama et les fichiers de modèle initiaux. Une fois les modèles stockés sur votre machine, vous pouvez les exécuter et interagir avec eux entièrement hors ligne.
Comment Ollama gère-t-il la confidentialité de mes données ?
Ollama exécute les modèles localement sur votre matériel, ce qui signifie que vos prompts et les réponses des modèles ne quittent jamais votre machine et ne sont jamais envoyés à un serveur cloud pour traitement.
Quelles sont les exigences matérielles pour exécuter de grands modèles ?
Les performances du modèle dépendent fortement de la RAM et de la VRAM. Les petits modèles nécessitent généralement au moins 8 Go de RAM, tandis que les modèles plus grands comme les variantes 70B nécessitent typiquement 32 Go ou plus ainsi qu’un GPU compatible pour des vitesses acceptables.
Puis-je exécuter plusieurs modèles en même temps ?
Oui, Ollama prend en charge le chargement simultané de plusieurs modèles si votre système dispose de suffisamment de mémoire disponible. Vous pouvez ajuster le nombre maximum de modèles chargés à l’aide de la variable d’environnement OLLAMA_MAX_LOADED_MODELS.
Comment mettre à jour les modèles que j’ai téléchargés ?
Vous pouvez mettre à jour un modèle vers la dernière version en exécutant la commande ollama pull suivie du nom du modèle. Cela téléchargera tous les nouveaux poids ou configurations disponibles dans la bibliothèque Ollama.
Qu’est-ce que la quantification et pourquoi est-ce important ?
La quantification compresse les grands modèles pour qu’ils tiennent sur du matériel grand public en réduisant la précision de leurs poids. Elle vous permet d’exécuter des modèles puissants avec moins de mémoire, bien que cela puisse légèrement affecter la précision des réponses.
Outils similaires
 Devin DesktopDevin Desktop (anciennement Windsurf) est l'IDE d'IA agentique de Cognition, qui combine une compréhension approfondie de la base de code avec des
 QoderQoder est une plateforme de codage IA agentique qui automatise des workflows complexes grâce à des agents autonomes et une compréhension approfondie
 ReplitReplit est un IDE collaboratif basé sur navigateur, doté d'outils d'IA intégrés pour un codage fluide, un déploiement instantané et une édition