
Replicate
Outils de développementMis à jour le 4 octobre 2026
Replicate vous permet d'exécuter des modèles d'apprentissage automatique dans le cloud via une API simple pour des workflows de production fluides.
Nous pouvons percevoir une commission si vous vous inscrivez via nos liens. Cela n’influence pas nos avis.
Qu’est-ce que Replicate ?
Replicate fonctionne comme une API basée sur le cloud qui vous permet d’exécuter des modèles d’apprentissage automatique sans toucher à un seul pilote GPU ni configurer un serveur Linux. Vous choisissez un modèle dans leur bibliothèque ou importez le vôtre à l’aide de Cog, et ils gèrent la mise à l’échelle, les files d’attente et l’orchestration des conteneurs. Cela élimine le casse-tête du « ça marche sur ma machine » en standardisant l’environnement dans des conteneurs Docker prêts pour la production. En pratique, vous pouvez intégrer Stable Diffusion ou Llama 3 dans votre application avec une simple requête POST au lieu de constituer toute une équipe MLOps. Les temps de démarrage à froid peuvent être gênants pour les applications en temps réel, mais le modèle de paiement à la seconde évite les factures énormes pendant les heures creuses. Cela vous permet de vous concentrer sur la logique du produit plutôt que de lutter contre les conflits de versions CUDA. Utilisez Replicate pour lancer des fonctionnalités d’IA en quelques jours, mais cherchez ailleurs si vous avez besoin de la latence la plus basse possible pour le trading haute fréquence ou le jeu vidéo.
Comment commencer à utiliser Replicate ?
Commencez par vous connecter avec votre compte GitHub. Cela lie votre identité et votre facturation à une plateforme familière. Vous trouverez immédiatement vos jetons API dans les paramètres de votre compte. Récupérez le jeton commençant par r8_ et conservez-le en sécurité. Cela vous permet d’authentifier les requêtes sans gérer une infrastructure serveur complexe.
Parcourez la bibliothèque de modèles pour trouver un point de départ. Que vous ayez besoin de Llama pour le texte ou de Stable Diffusion pour les images, tout est prêt à l’emploi. Vous pouvez tester les modèles directement dans le navigateur à l’aide du playground. C’est un moyen rapide de vérifier si un modèle convient à vos données spécifiques avant d’écrire le moindre code, ce qui vous évite de gaspiller des crédits sur des architectures incompatibles.
Installez la bibliothèque Python ou JavaScript de Replicate. Une simple commande pip ou npm prépare le client sur votre machine locale. Utilisez le jeton API comme variable d’environnement plutôt que de le coder en dur. Vos identifiants restent ainsi protégés lors de la publication sur des dépôts publics. Vous êtes maintenant prêt à exécuter des prédictions avec seulement quelques lignes de code.
Les prédictions se font via un simple appel de fonction. Transmettez vos entrées sous forme de dictionnaire et attendez les résultats. Replicate se charge du gros du travail : démarrer les GPU et les arrêter une fois terminé. La contrepartie : un léger délai de démarrage à froid pour les modèles rarement utilisés. Point positif : vous ne payez que pour les secondes exactes pendant lesquelles votre code s’exécute.
À qui s’adresse-t-il ?
Le prototypeur pressé
Vous avez un week-end pour prouver qu’une fonctionnalité d’IA fonctionne sans perdre 48 heures sur des Dockerfiles ou des pilotes CUDA. Vous intégrez un modèle dans votre application via une requête POST et passez directement aux tests utilisateurs. Vous pouvez valider l’adéquation produit-marché avant d’embaucher un ingénieur ML coûteux.
Le développeur frontend avant tout
Vous connaissez React ou Next.js mais trouvez l’orchestration GPU intimidante. Replicate fournit une API propre qui ressemble à n’importe quel autre outil SaaS, vous permettant de déclencher des exécutions lourdes de Llama 3 ou Stable Diffusion depuis une simple fonction serverless. Le développement web et l’apprentissage automatique complexe se rejoignent sans courbe d’apprentissage abrupte.
L’expérimentateur soucieux du budget
Vous devez exécuter des modèles massifs mais ne pouvez pas justifier une facture de GPU inactif de 400 $/mois. Le modèle de paiement à la seconde garantit que vous ne dépensez de l’argent que lorsque votre code s’exécute réellement, ce qui fonctionne bien pour les applications à trafic sporadique ou faible. La contrepartie : un délai de démarrage à froid de 10 à 20 secondes pour les modèles moins populaires. Cela rend malgré tout le matériel haut de gamme accessible aux fondateurs solo et aux projets perso.
L’explorateur open source
Vous voulez exploiter les derniers fine-tunings de la communauté sans limitations matérielles locales. Replicate héberge des milliers de modèles de niche que vous pouvez permuter en changeant simplement une chaîne de caractères dans votre appel API. Si les modèles populaires sont toujours « chauds », certains modèles publiés par la communauté peuvent être instables ou lents à démarrer. Dans tous les cas, vous disposez d’une bibliothèque massive et prête à l’emploi pour des tâches spécialisées comme la suppression d’arrière-plan ou le clonage vocal.
Celui qui empaquette ses propres modèles
Vous avez entraîné un modèle spécifique et avez besoin d’un moyen stable de le partager avec votre équipe. En utilisant Cog, vous empaquetez votre environnement dans un conteneur standardisé que Replicate gère à grande échelle. Fini les erreurs « ça marche sur ma machine » lors du passage de la recherche à la production.
Tarifs de Replicate
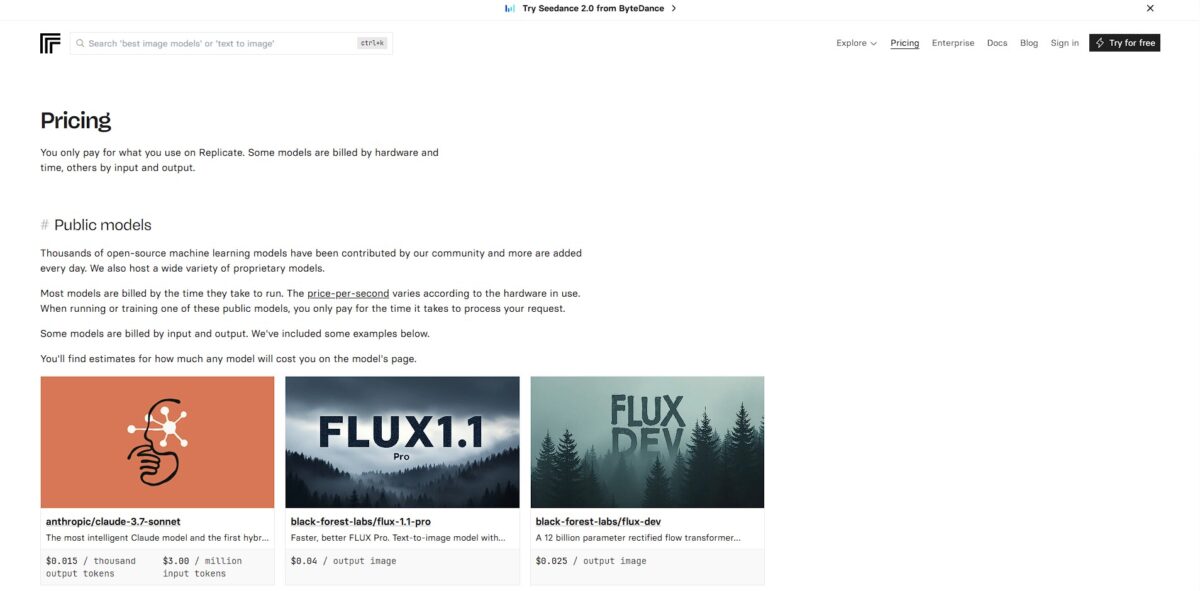
Replicate fonctionne sur un modèle de paiement à l’usage qui vous facture le temps de calcul exact que vos modèles occupent sur leur matériel. Ce fonctionnement évite les frais liés à la location de GPU inactifs, vous permettant de passer de zéro à des milliers de requêtes sans toucher à un pilote. Vous ne payez que pour le temps de traitement actif sur les modèles publics ; la configuration et les périodes d’inactivité sont gratuites. Les pics expérimentaux ou le trafic irrégulier n’entraînent aucune pénalité financière.
Facturés à la seconde d’exécution. Les prix dépendent du matériel spécifique requis, comme un Nvidia T4 (0,000225 $/sec) ou un A100 haut de gamme (0,001400 $/sec).
Proposent souvent une tarification prévisible basée sur la sortie. Vous pourriez payer 0,06 $ par image pour Flux 1.1 Pro ou 0,05 $ par seconde pour certains modèles vidéo spécifiques.
J’ai remarqué que si le temps de configuration est gratuit sur les modèles publics, les déploiements privés facturent la totalité du temps pendant lequel une instance reste en ligne, y compris le temps d’inactivité.
Comprend des crédits initiaux pour tester les modèles dans le playground avant d’ajouter une carte de crédit. Cela suffit pour vérifier le résultat d’un modèle avant de vous engager sur un budget de production.
Fonctionnalités clés de Replicate
Exécutez des modèles open source via une API normalisée
Vous échappez au casse-tête des versions locales de CUDA qui ne concordent pas ou de la gestion d’environnements virtuels Python. Vous pouvez tester Llama ou Stable Diffusion dans votre application avec quelques lignes de code.
Passez automatiquement de zéro à des milliers de GPU
Vous ne payez que les secondes pendant lesquelles votre modèle traite réellement une requête, sans factures coûteuses pour des serveurs inactifs. Pour de petits projets, l’hébergement de modèles de niche ou massifs devient financièrement viable.
Déployez vos propres modèles empaquetés avec Cog
Vous enveloppez le résultat de votre entraînement dans un conteneur prêt pour la production, avec toutes les dépendances système nécessaires. Votre modèle tourne exactement de la même façon sur Replicate que sur votre machine locale.
Accédez à une immense bibliothèque de poids fournis par la communauté
Vous passez d’un modèle fine-tuné à l’autre pour la génération d’images ou le traitement de texte sans installer une infrastructure pour chacun. La page de découverte facilite la recherche de versions optimisées de modèles populaires déjà « préchauffées », ce qui réduit le temps passé à chercher un modèle.
Intégrez des webhooks pour gérer de longues tâches asynchrones
Votre application reçoit une notification dès qu’une lourde génération vidéo ou un fine-tuning complexe se termine. C’est important, car vous n’avez ni à garder une connexion ouverte ni à interroger sans cesse le service.
Avantages et inconvénients de Replicate
Avantages
Replicate supprime la corvée de gérer des grappes de GPU ou l’enfer de l’environnement local. Vous appelez une API et vous récupérez une prédiction. Vous pouvez prototyper des fonctionnalités d’IA en quelques minutes sans toucher au moindre Dockerfile. La bibliothèque de modèles est vaste et couvre tout, de Llama à SDXL. Lors des tests, les temps de démarrage à froid restent gérables, même s’ils se remarquent. Vous ne payez que les secondes pendant lesquelles votre code s’exécute vraiment, ce qui économise des milliers de dollars en coûts d’inactivité dans le cloud pour les applications à faible trafic. Utilisez-le pour l’expérimentation rapide et l’inférence prête pour la production, sans le casse-tête de l’infrastructure.
Inconvénients
Les coûts peuvent s’envoler si votre trafic est élevé et régulier. Une instance dédiée sur AWS peut revenir moins cher pour de grosses charges. Au-delà d’un certain seuil, vos marges disparaissent. Le déploiement d’un modèle personnalisé exige une configuration Cog, qui a sa propre courbe d’apprentissage. Vous trouverez peut-être la couche d’abstraction frustrante si vous avez besoin d’optimisations matérielles fines et bas niveau. J’ai remarqué que les journaux restent un peu maigres quand la construction d’un modèle personnalisé échoue. C’est important, car le débogage devient une boîte noire. Tenez-vous-en à Replicate pour l’agilité, mais envisagez d’autres pistes pour un volume massif et constant.
Utilisez Replicate si vous voulez…
- Exécuter des modèles open source sans gérer une lourde infrastructure GPU.
- Déployer des modèles d’apprentissage automatique personnalisés en une seule commande.
- Passer instantanément d’un appel API à des milliers.
- Ne payer que les secondes exactes d’exécution de votre code.
- Expérimenter avec Flux ou Llama via un seul point de terminaison.
- Intégrer rapidement la génération d’images avancée dans votre application web.
- Créer des fonctionnalités IA prêtes pour la production sans équipe DevOps.
- Vous concentrer sur la création de produits plutôt que sur le provisionnement de serveurs.
Alternatives à Replicate
Avis sur Replicate
Replicate est le cheat code ultime pour déployer des fonctionnalités IA. Je peux intégrer un modèle dans mon backend avec quelques lignes de code et sans aucun tracas d’infrastructure. Les démarrages à froid sont pénibles pour les applications en temps réel, mais pour le traitement asynchrone, c’est imbattable.
La bibliothèque de modèles communautaires est immense, mais c’est un peu un pari. Certains modèles sont très solides, tandis que d’autres tombent en panne sans avertissement. J’adore la facturation à la seconde pour les tests, même si les coûts peuvent grimper rapidement si on n’y prend pas garde.
Parfait pour passer d’un prototype sur ordinateur portable à une API évolutive en quelques minutes. Cog rend l’empaquetage des modèles personnalisés relativement simple. Le support est lent à répondre, donc vous êtes surtout livré à vous-même si quelque chose tourne mal avec un déploiement spécifique.
Idéal pour essayer les derniers modèles open source sans louer un GPU puissant. L’interface web est claire et facilite la présentation de démos à des parties prenantes non techniques. C’est certainement plus cher qu’AWS brut si vous avez un volume élevé, mais le temps gagné en vaut la peine.
Questions fréquentes
Quels langages de programmation sont pris en charge par Replicate ?
Replicate fournit des bibliothèques clientes officielles pour Python et JavaScript, mais son API HTTP permet l’intégration avec n’importe quel langage de programmation capable d’effectuer des requêtes web.
Qu’est-ce que Cog et pourquoi en ai-je besoin ?
Cog est un outil open source utilisé pour empaqueter des modèles d’apprentissage automatique dans des conteneurs standards. Il simplifie le processus de définition des dépendances d’environnement et de la logique de prédiction afin que votre modèle personnalisé puisse fonctionner de manière cohérente dans le cloud.
Replicate prend-il en charge les modèles privés ?
Oui, vous pouvez créer des modèles privés qui ne sont accessibles qu’à vous ou à votre organisation. Ceux-ci s’exécutent sur du matériel dédié afin de garantir des performances constantes sans temps d’attente en file.
Comment les démarrages à froid sont-ils gérés sur la plateforme ?
Pour les modèles publics qui n’ont pas été utilisés récemment, Replicate doit charger le modèle dans la mémoire GPU avant de traiter une requête. Pour les modèles publics, ce temps de configuration n’est pas facturé ; vous ne payez que le temps de traitement actif.
Puis-je affiner (fine-tuner) des modèles existants sur Replicate ?
Replicate prend en charge le fine-tuning pour plusieurs modèles open source populaires, notamment Flux pour les images et HunyuanVideo pour la vidéo. Vous pouvez effectuer ces entraînements via l’interface web ou de manière programmatique via l’API.
Quelles options matérielles sont disponibles pour exécuter les modèles ?
Les utilisateurs peuvent choisir parmi diverses configurations matérielles, y compris des CPU et plusieurs niveaux de GPU comme le Nvidia T4, L40S, A100 et H100, afin d’équilibrer coût et vitesse de traitement.
Replicate propose-t-il un essai gratuit ?
Les nouveaux utilisateurs reçoivent généralement une quantité limitée de crédit de calcul gratuit pour tester les modèles dans le playground ou via l’API avant d’être invités à ajouter une carte de crédit pour une facturation à l’usage.
Outils similaires
 Devin DesktopDevin Desktop (anciennement Windsurf) est l'IDE d'IA agentique de Cognition, qui combine une compréhension approfondie de la base de code avec des
 QoderQoder est une plateforme de codage IA agentique qui automatise des workflows complexes grâce à des agents autonomes et une compréhension approfondie
 ReplitReplit est un IDE collaboratif basé sur navigateur, doté d'outils d'IA intégrés pour un codage fluide, un déploiement instantané et une édition