
RunPod
Outils de développementMis à jour le 4 octobre 2026
RunPod est une plateforme cloud évolutive qui fournit des ressources GPU à la demande ainsi que des points de terminaison sans serveur pour l'entraînement et l'inférence de modèles d'IA.
Nous pouvons percevoir une commission si vous vous inscrivez via nos liens. Cela n’influence pas nos avis.
Qu’est-ce que RunPod ?
RunPod fonctionne comme une place de marché GPU distribuée mondialement, où vous pouvez louer une puissance de calcul haut de gamme à l’heure pour lancer des instances Stable Diffusion ou entraîner des LLM, sans les contraintes des contrats de cloud d’entreprise. Il contourne la pénurie de matériel local en vous connectant à un réseau de fournisseurs privés et d’exploitants de centres de données, vous permettant de déployer des conteneurs Docker en quelques secondes sur des RTX 3090 ou des A100. J’ai remarqué que l’interface utilisateur est conçue pour la rapidité, bien que le marché des instances spot signifie que votre pod pourrait disparaître si quelqu’un enchérit plus haut. C’est important, car cela réduit considérablement le coût des expérimentations en IA par rapport aux hyperscalers à prix fixe. Utilisez des templates gérés par la communauté pour un démarrage rapide, mais passez à des instances dédiées si votre entraînement ne tolère aucune interruption.
Comment commencer à utiliser RunPod ?
Commencez par vous inscrire sur la console RunPod et par vérifier votre adresse e-mail. Vous devrez recharger du crédit immédiatement, car la plateforme fonctionne selon un modèle prépayé. Le dépôt minimum est faible, ce qui est idéal pour tester une seule RTX 4090 sans grand engagement. Louer une puissance de calcul haut de gamme à l’heure plutôt que d’acheter une station de travail à cinq chiffres abaisse la barrière d’entrée pour entraîner des modèles de niche ou exécuter des inférences gourmandes en calcul.
Astuce: activez immédiatement l’authentification à deux facteurs pour protéger votre crédit.Ensuite, parcourez les sections « GPU Cloud » ou « Serverless » pour choisir votre matériel. Vous pouvez sélectionner des cartes graphiques spécifiques comme la A100 ou des instances communautaires moins chères. Chaque « pod » nécessite un template ; le template officiel PyTorch convient généralement le mieux aux charges de travail d’IA. Cela vous évite le cauchemar des installations manuelles de pilotes CUDA. Des environnements préconfigurés vous permettent de commencer à coder en quelques minutes au lieu de résoudre des incompatibilités de noyau, même si les pods communautaires peuvent être moins fiables que ceux issus de centres de données sécurisés.
Conclusion: vérifiez les exigences en VRAM avant le déploiement pour éviter les erreurs de mémoire insuffisante sur des cartes graphiques plus petites.Lancez votre pod et attendez environ soixante secondes que le conteneur s’initialise. Vous pouvez vous connecter via un Jupyter Lab basé sur le web ou utiliser SSH pour une intégration avec un IDE local. Je préfère la méthode SSH, car elle me permet d’utiliser des extensions VS Code directement sur le GPU distant. Cela transforme un ordinateur portable ordinaire en une machine d’IA spécialisée, en combinant la réactivité de l’édition locale avec la puissance de calcul brute d’un H100 distant et un terminal professionnel pour les scripts complexes.
Conclusion: enregistrez votre clé publique SSH dans les paramètres RunPod pour éviter la demande de mot de passe à chaque connexion.Enfin, gérez vos données à l’aide de volumes réseau si vous souhaitez conserver vos jeux de données entre plusieurs sessions. Le stockage standard du pod est éphémère, donc tout ce qui ne se trouve pas dans un volume disparaît lorsque vous supprimez l’instance. Cette configuration protège vos poids et journaux même si vous passez d’un GPU économique pour le débogage à un GPU puissant pour l’entraînement. Vous payez un faible coût récurrent pour le stockage lui-même, mais les volumes persistants dissocient votre puissance de calcul coûteuse de vos précieuses données : un simple arrêt de routine ne peut donc pas effacer des jours de progrès d’entraînement.
Conclusion: mettez toujours un pod en « Stop » pour économiser de l’argent tout en conservant les données, mais ne le supprimez (« Terminate ») que lorsque vous avez complètement terminé.
À qui s’adresse-t-il ?
Le chercheur indépendant.
Vous avez besoin de VRAM NVIDIA haut de gamme pour entraîner un LoRA personnalisé ou affiner un LLM sans payer le prix à cinq chiffres d’une station de travail personnelle. En louant une A100 à l’heure, vous pouvez tester des hypothèses sur du matériel autrement inaccessible. Cela crée des conditions équitables pour les expérimentateurs individuels face aux laboratoires financés par du capital-risque.
L’ingénieur en inférence
Vous souhaitez héberger une API pour une application d’IA générative qui ne coûte que lorsque quelqu’un appelle réellement le point de terminaison. Les GPU sans serveur démarrent des conteneurs lors des pics de trafic et redescendent à zéro pendant les périodes calmes. Cela empêche votre facture cloud de dévorer vos marges pendant que votre application est inactive. J’ai remarqué que la technologie FlashBoot réduit les démarrages à froid à quelques secondes seulement, ce qui rend cela viable pour les applications en temps réel.
L’utilisateur avancé de Docker
Si votre environnement est déjà conteneurisé, vous pouvez déployer votre stack spécifique sur un GPU distant en environ soixante secondes. Cela contourne « l’enfer des dépendances » lié aux installations manuelles de pilotes CUDA sur les distributions Linux locales. Vous passez votre temps à écrire du Python plutôt qu’à déboguer des incompatibilités de noyau. L’inconvénient est que vous devez être rigoureux avec les volumes réseau pour stocker durablement les données.
Le développeur VS Code
Vous préférez votre IDE local mais avez besoin de la puissance de calcul brute d’un cluster H100 distant. En vous connectant via SSH, votre ordinateur portable standard se transforme en une machine d’IA spécialisée avec un accès complet au terminal et la prise en charge des extensions. Cela combine la réactivité locale avec la puissance d’un centre de données. J’ai constaté que la configuration précoce des clés publiques SSH élimine la gêne des demandes répétées de mot de passe.
L’amateur de Stable Diffusion
Vous souhaitez générer des lots entiers d’images haute résolution avec ComfyUI ou Automatic1111 sans surcharger votre GPU domestique. Avec des templates préconfigurés, vous pouvez lancer une interface web sur une RTX 4090 en quelques minutes. Vous itérez bien plus vite sur des workflows complexes comme ControlNet ou IP-Adapter. Cela convient bien aux sessions créatives exigeantes, mais est moins idéal pour des prompts occasionnels d’images uniques.
Tarifs de RunPod
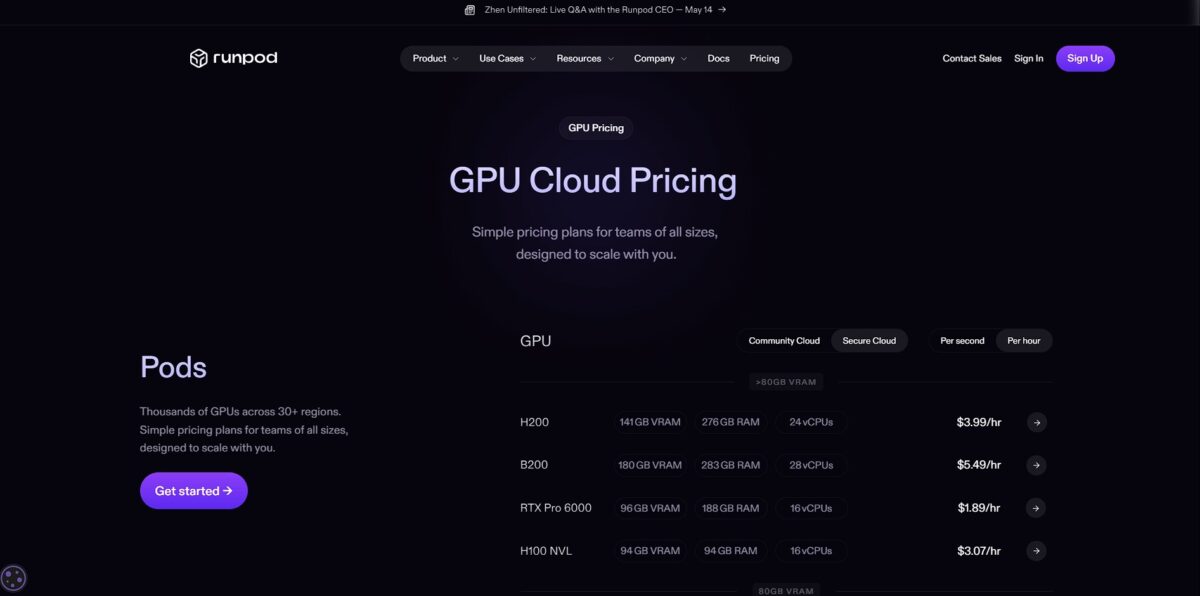
RunPod se passe de l’abonnement mensuel forfaitaire au profit d’un modèle de place de marché où vous louez du temps de GPU à la seconde ou à l’heure. Ce dispositif vous donne accès à du matériel haut de gamme comme le H100 ou l’A100 sans les fortes marges des fournisseurs cloud traditionnels. Vous payez exactement ce que vous consommez, ce qui évite de gaspiller de l’argent sur des instances inactives pendant de longues pauses d’entraînement. En contrepartie, les prix fluctuent : les coûts suivent la demande du réseau et le palier tarifaire retenu.
les instances Secure Cloud démarrent autour de 0,44 $/h pour une RTX 4090, tandis que les options Community Cloud pour la même puce peuvent descendre à 0,34 $/h. Ces pods restent les vôtres jusqu’à ce que vous les supprimiez, ce qui offre un environnement stable pour du développement complexe, sans risque d’arrêt soudain.
Vous ne payez que pendant l’exécution réelle de votre code, ce qui convient aux API d’inférence qui retombent à zéro dès que le trafic s’arrête.
Le coût de calcul baisse, mais le stockage reste une charge fixe distincte. Malgré cela, une facturation prévisible aide les équipes à budgéter l’hébergement de modèles sur la durée.
comptez 0,10 $/Go par mois pour les volumes de disque actifs.
Attention à un point : les pods arrêtés sont facturés au double pour le stockage (0,20 $/Go par mois), afin de décourager l’accumulation de ressources inutilisées. Cette politique impose une gestion rigoureuse des données.
Fonctionnalités clés de RunPod
Louez des GPU haut de gamme NVIDIA H100 ou A100 avec une facturation à la seconde
Vous évitez des investissements colossaux, car vous ne payez que les cycles de calcul réellement consommés par l’entraînement de votre modèle. Les chercheurs indépendants qui ne peuvent pas s’offrir une baie matérielle à 40 000 $ accèdent à la même classe de matériel.
Lancez des points de terminaison sans serveur qui se réduisent à zéro lorsqu’ils sont inactifs
Votre API reste réactive lors des pics de trafic, mais cesse de générer des coûts dès que les requêtes se tarissent. Cela évite les mauvaises surprises sur la facture dues à des ressources de calcul inactives dans le centre de données.
Déployez des conteneurs Docker personnalisés ou utilisez des templates préconfigurés pour PyTorch et Jupyter
Vous évitez l’enfer des dépendances lié à l’installation des pilotes CUDA et démarrez directement depuis votre notebook. Cela réduit de plusieurs heures le délai entre une idée et l’exécution d’un benchmark.
Associez un stockage réseau persistant à plusieurs pods
Vos checkpoints d’entraînement et vos grands jeux de données restent disponibles même lorsque vous changez de type de GPU ou redémarrez un pod. C’est important, car cela vous évite de perdre des jours de progression lorsqu’une instance spot est libérée.
Accédez au Community Cloud pour des tarifs plus avantageux ou au Secure Cloud pour répondre aux exigences de conformité
Vous choisissez entre des économies maximales sur la capacité inutilisée et du matériel dédié pour les données sensibles. Vous gardez la maîtrise du compromis entre prix et confidentialité.
Utilisez la CLI Flash pour envoyer des fonctions Python directement dans le cloud
Vous n’avez plus besoin de créer et de gérer des images, car la plateforme se charge de l’orchestration. Vous pouvez vous concentrer sur la logique applicative plutôt que sur l’infrastructure.
Avantages et inconvénients de RunPod
Avantages
RunPod fournit des GPU quand les hyperscalers affichent des erreurs « en rupture de stock ». Vous vous épargnez les appels commerciaux et l’attente d’une augmentation de quota. Lancez une H100 ou une RTX 4090 en moins d’une minute. La facturation à la seconde garantit que vous cessez de payer dès que votre script se termine. Les points de terminaison sans serveur se réduisent à zéro, ce qui supprime les coûts d’inactivité : vous ne payez que le calcul réellement utilisé. Utilisez le Secure Cloud pour la stabilité et le Community Cloud pour un maximum d’économies.
Inconvénients
Le modèle de place de marché implique des compromis en matière de stabilité. Les instances communautaires offrent des remises importantes, mais sont sujettes à des préemptions soudaines. Votre tâche d’entraînement peut être interrompue si quelqu’un surenchérit sur vous ; des volumes de stockage persistants sont donc nécessaires pour des checkpoints fréquents. Il lui manque l’écosystème de services étendu que l’on trouve chez AWS ou Google Cloud. Vous n’y trouverez ni bases de données SQL managées ni réseau d’entreprise. Montez toujours un volume réseau pour protéger vos données contre les arrêts inattendus des pods.
Utilisez RunPod si vous voulez…
- Louer des GPU haut de gamme pour l’entraînement d’IA avec une facturation à la seconde.
- Déployer des points de terminaison d’inférence sans serveur sans gérer d’infrastructure.
- Accéder instantanément à des clusters H100 ou A100 pour les grands modèles.
- Exécuter des pods persistants avec un accès root et SSH complet.
- Faire évoluer vos charges de travail d’IA en production sans effort à l’échelle mondiale.
- Affiner des LLM grâce à une puissance de calcul économique fournie par la communauté.
- Surveiller la température du GPU et l’utilisation de la mémoire directement en temps réel.
- Éviter les contrats cloud complexes grâce à une facturation transparente à la seconde.
Alternatives à RunPod
Avis sur RunPod
Excellent pour le développement en IA. Travailler dans un environnement compatible CUDA et GPU est très important, et RunPod le propose avec une installation simple.
Excellente interface utilisateur et GPU disponibles instantanément. Pour un service d’hébergement cloud de milieu de gamme, c’est le meilleur choix.
Facile à utiliser et la meilleure qualité pour ce prix. Le support est également relativement simple comparé aux grands fournisseurs.
Excellent pour les startups. C’est vraiment flexible et facile à utiliser. On peut déployer sans problème des templates prêts à l’emploi et démarrer immédiatement.
Questions fréquentes
Quelle est la différence entre Secure Cloud et Community Cloud ?
Secure Cloud fonctionne dans des centres de données haut de gamme offrant fiabilité et sécurité de niveau entreprise, tandis que Community Cloud utilise un réseau pair-à-pair de fournisseurs individuels de GPU. Secure Cloud convient mieux aux charges de travail de production et aux données sensibles, tandis que Community Cloud propose des tarifs nettement plus avantageux pour le développement et les tests non critiques.
Comment fonctionne le stockage persistant ?
Avec RunPod, vous pouvez créer des volumes réseau pouvant être attachés à vos pods. Ces volumes garantissent que vos données, modèles et code restent disponibles même après la suppression ou le redémarrage d’un pod, et vous ne payez que pour l’espace de stockage réellement utilisé.
Que sont les instances spot ?
Les instances spot sont disponibles à un tarif nettement réduit par rapport aux prix à la demande. L’inconvénient est qu’elles peuvent être interrompues de manière anticipée si un utilisateur à la demande a besoin de la capacité. Elles conviennent donc parfaitement aux tâches d’entraînement tolérantes aux pannes, mais sont moins adaptées aux services web persistants.
Puis-je utiliser des images Docker personnalisées ?
Oui, vous pouvez déployer des pods avec n’importe quelle image Docker publique ou privée provenant de registres tels que Docker Hub ou GitHub Container Registry. Cela vous permet de préconfigurer votre environnement avec des pilotes, des bibliothèques ou du code applicatif spécifiques.
RunPod prend-il en charge les déploiements sans serveur ?
Oui, avec RunPod Serverless, vous pouvez déployer des modèles d’IA en tant que points de terminaison qui se réduisent à zéro en cas de non-utilisation. Vous ne payez que pour la durée exacte de puissance de calcul GPU nécessaire au traitement de chaque requête, ce qui est extrêmement rentable pour les tâches d’inférence à trafic variable.
Comment gérer des clusters multi-GPU ?
RunPod propose des Instant Clusters, qui vous permettent de déployer plusieurs nœuds avec des connexions haute vitesse. Ils sont conçus pour l’entraînement distribué de modèles à grande échelle, lorsque la mémoire d’un seul GPU ne suffit pas.
Outils similaires
 Devin DesktopDevin Desktop (anciennement Windsurf) est l'IDE d'IA agentique de Cognition, qui combine une compréhension approfondie de la base de code avec des
 QoderQoder est une plateforme de codage IA agentique qui automatise des workflows complexes grâce à des agents autonomes et une compréhension approfondie
 ReplitReplit est un IDE collaboratif basé sur navigateur, doté d'outils d'IA intégrés pour un codage fluide, un déploiement instantané et une édition