
RunPod
開発者ツール更新日:2026年10月4日
RunPodは、AIモデルのトレーニングと推論のために、オンデマンドのGPUリソースとサーバーレスエンドポイントを提供するスケーラブルなクラウドプラットフォームです。
当サイトのリンクから登録すると、紹介料を受け取る場合があります。レビューの内容には影響しません。
RunPodとは?
RunPodはグローバルに分散されたGPUマーケットプレイスとして機能し、企業向けクラウド契約の手間をかけずに、Stable Diffusionのインスタンスを起動したりLLMをトレーニングしたりするために、ハイエンドの計算能力を時間単位でレンタルできます。プライベートプロバイダーとデータセンター運営者のネットワークに接続することで、ローカルハードウェアの不足を回避し、数秒でRTX 3090やA100上にDockerコンテナをデプロイできます。私が気づいたのは、ユーザーインターフェースが速度重視で設計されている一方で、スポットインスタンス市場のため、より高い入札者が現れるとPodが消えてしまう可能性があるということです。これは重要です。なぜなら、固定価格のハイパースケーラーと比較して、AI実験のコストを劇的に削減できるからです。手早く始めるにはコミュニティ管理のテンプレートを利用しつつ、トレーニングが中断に耐えられない場合は専用インスタンスに切り替えましょう。
RunPodの始め方
まず、RunPodコンソールにサインアップし、メールアドレスを確認してください。プラットフォームはプリペイド方式を採用しているため、すぐに残高をチャージする必要があります。最低入金額は少額なので、大きな出費をせずにRTX 4090を1枚だけ試すのに理想的です。数万ドルのワークステーションを購入する代わりにハイエンドの計算能力を時間単位でレンタルすることで、ニッチなモデルのトレーニングや計算負荷の高い推論を実行する際の参入障壁が下がります。ヒント:残高を保護するために、すぐに二要素認証を有効にしましょう。
次に、「GPU Cloud」または「Serverless」セクションを参照して、ハードウェアを選択してください。A100などの特定のグラフィックカードや、より安価なコミュニティ提供のインスタンスを選ぶことができます。各「Pod」にはテンプレートが必要で、公式のPyTorchテンプレートは通常、AIワークロードに最適です。これにより、手動でのCUDAドライバーインストールという悪夢を回避できます。欠点は、コミュニティPodが安全なデータセンターのものよりも信頼性が低い可能性があることです。事前設定済みの環境により、カーネルの非互換性を解決する代わりに、数分でコーディングを始められます。
ポイント: 小さいグラフィックカードでのメモリ不足エラーを避けるため、デプロイ前にVRAM要件を確認しましょう。Podを起動し、コンテナが初期化されるまで約60秒待ちます。WebベースのJupyter Labで接続するか、ローカルIDE統合のためにSSHを使用できます。私はSSH方式を好みます。リモートGPU上で直接VS Code拡張機能を使用できるからです。これにより、普通のノートパソコンが専用のAIマシンに変わります。ローカル編集の応答性に、リモートH100の圧倒的な計算能力と、複雑なスクリプトに対応するプロフェッショナルなターミナルを組み合わせられます。
ポイント: 接続のたびにパスワードプロンプトをスキップするため、RunPodの設定に公開SSHキーを保存しましょう。最後に、複数のセッション間でデータセットを保持したい場合は、ネットワークボリュームを使ってデータを管理してください。通常のPodストレージは一時的なもので、ボリューム内にないものはインスタンスを終了すると消えてしまいます。この構成により、デバッグ用の低コストGPUからトレーニング用の高性能GPUに切り替えても、重みとログが保護されます。ストレージ自体にわずかな継続コストがかかりますが、永続ボリュームにより高価な計算能力と貴重なデータを分離できるため、通常のシャットダウンで数日分のトレーニング進捗が失われることはありません。
ポイント: お金を節約しつつデータを保持するため、Podは常に「Stop」で停止し、完全に作業が終わるまで「Terminate」しないようにしましょう。
どんな人に向いているか?
独立系研究者
カスタムLoRAをトレーニングしたりLLMをファインチューニングしたりするには、ハイエンドのNVIDIA VRAMが必要ですが、数万ドルもする個人用ワークステーションを購入する必要はありません。A100を時間単位でレンタルすることで、通常は手が届かないハードウェアで仮説を検証できます。ベンチャー資金を得たラボと競争する個人の実験者にとって、公平な競争環境が整います。
推論エンジニア
誰かが実際にエンドポイントを呼び出したときのみコストが発生する、生成AIアプリ用のAPIをホストしたいと考えています。サーバーレスGPUはトラフィックの急増時にコンテナを起動し、閑散時にはゼロにスケールダウンします。アプリがアイドル状態のときに、クラウド料金が利益を食い潰すことがなくなります。私が気づいたのは、FlashBoot技術によりコールドスタートが数秒に短縮され、リアルタイムアプリでの利用が実現可能になったことです。
Dockerパワーユーザー
環境がすでにコンテナ化されている場合、特定のスタックを約60秒でリモートGPUにデプロイできます。これにより、ローカルLinuxディストリビューションでの手動CUDAドライバーインストールの「依存関係地獄」を回避できます。カーネルの非互換性をデバッグする代わりに、Pythonを書くことに時間を使えます。欠点は、データを永続化するためにネットワークボリュームをきちんと管理する必要があることです。
VS Code開発者
ローカルIDEを好みますが、リモートのH100クラスターの圧倒的な計算能力が必要です。SSH経由で接続することで、標準的なノートパソコンが、完全なターミナルアクセスと拡張機能サポートを備えた専用AIマシンに変わります。ローカルの応答性とデータセンターのパフォーマンスを両立できます。私が気づいたのは、公開SSHキーを早めに設定しておくと、繰り返しのパスワードプロンプトの煩わしさがなくなることです。
Stable Diffusion愛好家
ComfyUIやAutomatic1111を使って、自宅のGPUに負担をかけずに高解像度画像のバッチ全体を生成したいと考えています。事前設定済みのテンプレートにより、数分でRTX 4090上にWeb UIを起動できます。ControlNetやIP-Adapterのような複雑なワークフローをはるかに速く反復できます。要求の厳しいクリエイティブセッションには適していますが、気軽な単発の画像プロンプトにはあまり向いていません。
RunPodの料金
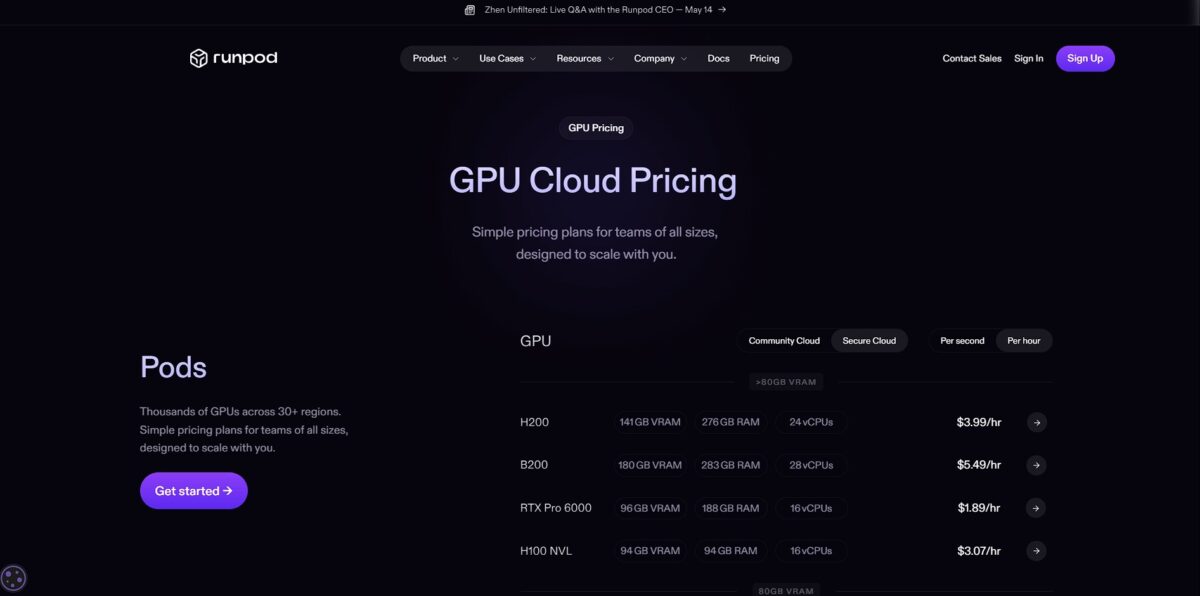
RunPodは一律の月額サブスクリプションではなく、GPU時間を秒単位または時間単位でレンタルするマーケットプレイス型モデルを採用しています。この構成により、従来のクラウドプロバイダーの高額な上乗せ料金なしに、H100やA100のようなハイエンドハードウェアにアクセスできます。使った分だけ支払うので、長いトレーニングの休止期間中に、使われていないインスタンスにお金を無駄にすることはありません。欠点は価格の変動性です。コストは現在のネットワーク需要と選択した価格帯に応じて変動します。
これらのPodは削除するまであなたのものなので、突然の終了リスクなしに、複雑な開発作業のための安定した環境が得られます。
実際にコードが実行されているときのみ支払うため、トラフィックが減少するとすぐにゼロにスケールする推論APIに適しています。
計算コストは下がるものの、ストレージは別途の固定費用として残ります。それでも、予測可能な請求は、チームがモデルの長期ホスティングの予算を立てるのに役立ちます。
重要な「落とし穴」は、停止中のPodには未使用リソースの蓄積を防ぐため2倍のレート(月あたり0.20ドル/GB)でストレージが課金されることです。このポリシーにより、規律あるデータ管理が求められます。
RunPodの主な機能
NVIDIA H100やA100などのハイエンドGPUを秒単位でレンタルできます
モデルトレーニングが実際に消費する計算サイクルの分だけ支払うため、莫大な設備投資コストを回避できます。4万ドルのハードウェアラックを買う余裕のない個人研究者でも、同クラスのハードウェアを利用できます。
アイドル時にゼロまでスケールするサーバーレスエンドポイントを起動できます
トラフィックが急増してもAPIは素早く応答し続け、リクエストが途絶えた瞬間にコストは発生しなくなります。データセンターで遊んでいる計算リソースによる「請求ショック」はもうありません。
カスタムDockerコンテナをデプロイするか、PyTorchやJupyter向けの事前設定済みテンプレートを利用できます
CUDAドライバーのインストールにつきものの「依存関係地獄」を避け、すぐにノートブックで作業を始められます。アイデアからベンチマーク実行までの時間を数時間短縮できます。
永続的なネットワークストレージを複数のPodに接続できます
GPUの種類を変えたりPodを再起動したりしても、トレーニングのチェックポイントや大規模なデータセットはそのまま利用できます。これが重要な理由は、スポットインスタンスが解放されても何日分もの進捗を失わずに済むからです。
低価格のCommunity Cloudか、コンプライアンス要件に対応するSecure Cloudを利用できます
余剰キャパシティによる最大限の節約か、機密データ向けの専用ハードウェアかを選べます。価格とプライバシーのバランスは自分で決められます。
Flash CLIを使って、Python関数をそのままクラウドに送り込めます
オーケストレーションをプラットフォームに任せるので、イメージのビルドや管理が不要になります。インフラではなくアプリケーションのロジックに集中できます。
RunPodの長所と短所
長所
RunPodは、ハイパースケーラーが「在庫切れ」エラーを出すときでもGPUを提供してくれます。営業との商談やクォータ承認の待ち時間は不要です。H100やRTX 4090を1分足らずで起動できます。秒単位の課金なので、スクリプトが終わった瞬間に支払いも止まります。サーバーレスエンドポイントはゼロまでスケールするためアイドル時のコストがなくなり、実際に使った計算分だけを支払えば済みます。安定性を求めるならSecure Cloud、最大限の節約ならCommunity Cloudを使いましょう。
短所
マーケットプレイス型のモデルには、安定性とのトレードオフがあります。コミュニティインスタンスは大幅に割安ですが、突然のプリエンプション(強制停止)が起こりがちです。誰かに高値で競り負けるとトレーニングジョブが中断されることもあるため、こまめなチェックポイント保存のための永続ストレージボリュームが欠かせません。AWSやGoogle Cloudのような幅広いサービスのエコシステムもありません。マネージドSQLデータベースやエンタープライズ向けネットワーク機能は用意されていません。予期せぬPodの停止からデータを守るため、必ずネットワークボリュームをマウントしておきましょう。
こんな時にRunPodを使いましょう…
- AIトレーニング用のハイエンドGPUを秒単位でレンタル。
- インフラ管理なしでサーバーレス推論エンドポイントをデプロイ。
- 大規模モデル向けにH100またはA100クラスタへ即座にアクセス。
- フルルート権限とSSHアクセスを備えた永続的なPodを実行。
- 本番環境のAIワークロードを世界中で容易にスケール。
- コミュニティ提供の低コストな計算能力を使ってLLMをファインチューニング。
- GPUの温度とメモリ使用率をリアルタイムで監視。
- 透明な秒単位課金により、複雑なクラウド契約を回避。
RunPodの代替ツール
RunPodのレビュー
AI開発に非常に適しています。CUDAとGPUに対応した作業環境で作業することは非常に重要であり、RunPodは簡単なセットアップでこれを提供します。
優れたユーザーインターフェースと即座に利用可能なGPU。中価格帯のクラウドホスティングサービスとしては最良の選択です。
使いやすく、この価格で最高の品質です。サポートも大手プロバイダーと比較して比較的スムーズです。
スタートアップに最適です。本当に柔軟で使いやすいです。すぐに使えるテンプレートを問題なくデプロイして、すぐに始めることができます。
よくある質問
Secure CloudとCommunity Cloudの違いは何ですか?
Secure Cloudはエンタープライズレベルの信頼性とセキュリティを備えた高性能データセンターで稼働するのに対し、Community Cloudは個々のGPU提供者によるピアツーピアネットワークを利用しています。Secure Cloudは本番環境のワークロードや機密データにより適しており、Community Cloudは重要度の低い開発やテスト用途に対して大幅に安価な料金を提供します。
永続ストレージはどのように機能しますか?
RunPodでは、Podに接続できるネットワークボリュームを作成できます。これらのボリュームにより、Podが終了または再起動された後もデータ、モデル、コードが保持され、実際に使用したストレージ容量分のみの料金が発生します。
スポットインスタンスとは何ですか?
スポットインスタンスは、オンデマンド価格と比較して大幅な割引価格で利用できます。欠点は、オンデマンドユーザーがそのキャパシティを必要とした場合、早期に終了される可能性があることです。そのため、フォールトトレラントなトレーニングジョブには最適ですが、永続的なウェブサービスにはあまり適していません。
カスタムDockerイメージを使用できますか?
はい、Docker HubやGitHub Container Registryなどのレジストリから、任意のパブリックまたはプライベートなDockerイメージを使用してPodをデプロイできます。これにより、特定のドライバー、ライブラリ、またはアプリケーションコードで環境を事前設定できます。
RunPodはサーバーレスデプロイをサポートしていますか?
はい、RunPod Serverlessを使用すると、使用されていないときにゼロにスケールするエンドポイントとしてAIモデルをデプロイできます。各リクエストの処理に必要な正確なGPU計算時間分のみの料金が発生するため、可変的なトラフィックの推論タスクに非常にコスト効率が良い方法です。
マルチGPUクラスターはどのように管理しますか?
RunPodはInstant Clustersを提供しており、高速接続を備えた複数のノードをデプロイできます。これは、単一のGPUのメモリでは不十分な大規模モデルの分散トレーニング用に設計されています。


