Semantic Scholar
データ分析更新日:2026年10月4日
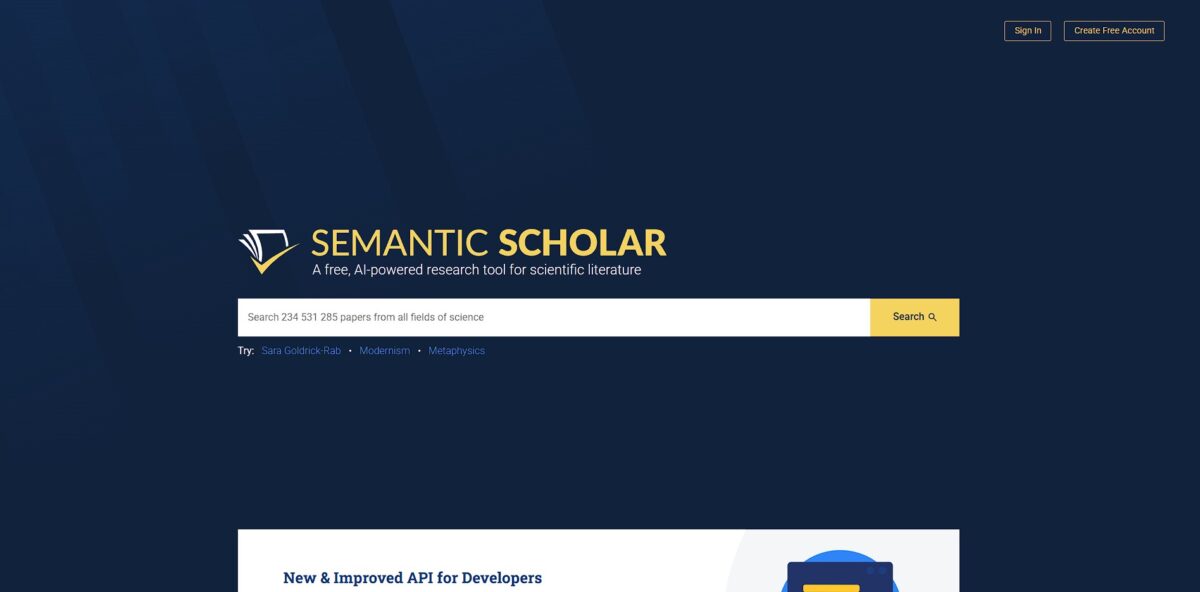
Semantic Scholarは、機械学習を活用して学術研究を発見・要約する、無料のAI搭載検索エンジンです。
当サイトのリンクから登録すると、紹介料を受け取る場合があります。レビューの内容には影響しません。
Semantic Scholarとは?
Semantic Scholarは、Allen Institute for AIによる非営利の検索エンジンで、2億件以上の論文をクロールし、長い抄録を手作業で読む手間を省いてくれます。単にキーワードを照合するだけでなく、機械学習を使って引用の背後にある実際の意図を抽出し、単に参考文献リストに載っているだけの論文ではなく、その研究に本当に影響を与えた論文を見分けて示します。コンピューターサイエンスや生物医学の分野では「TLDR」要約を表示するのが特に優れていると感じましたが、ニッチな人文学分野のカバー範囲は薄いと感じることがあります。このセマンティックなアプローチは、毎年発表される300万件もの論文に埋もれることなく、研究分野の進化を把握するのに役立ちます。文字の羅列を、たどれるつながりのグラフに変え、「必読」論文をより速く見つけられるようにします。
Semantic Scholarの始め方
まずはsemanticscholar.orgにアクセスし、検索バーを試してみましょう。アカウントがなくても2億件以上の論文コーパスを閲覧できるので、素早い事実確認に便利です。特定のトピックを入力し、検索結果に表示されるTLDRタグを確認してください。この一文の要約は、関係のないPDFを開かずにスキップする助けになります。
このエンジンをさらに活用するには、右上の「Create Free Account」をクリックしてください。Googleアカウントや所属機関のメールアドレスを使用できます。これによりライブラリ機能が解放され、論文を特定のフォルダに保存できるようになります。これにより、研究資料が整理されないまま大量のブラウザタブとして散らかるのを防げます。
論文をいくつか保存したら、そのフォルダの「Research Feed」をオンに切り替えてください。AIが保存内容を分析し、関連する新しいプレプリントや記事を毎日推薦してくれます。あなたのニッチな興味を学習してくれるパーソナライズされた発見キューのように感じられます。これにより、毎週同じキーワード検索を繰り返す手間が省けます。
あなたが著者であれば、検索結果で自分の名前を見つけて「Claim Author Page」を選択してください。これにより、自分が書いていない論文を削除したり、漏れている論文を追加したりして、出版記録を整理できます。また、誰かが自分の研究を引用した際に通知を受け取ることもできます。引用管理ツールにお金を払わずに、学術的な足跡を追跡する手間のかからない方法です。
このサイトはオープンアクセスのPDFを見つけるのに優れていますが、「Highly Influential Citations」の数がGoogle Scholarと異なることがあります。これは、Semantic Scholarがウェブ全体ではなく特定のデータソースに焦点を当てているために起こります。まずは発見のためのツールとして使い、完全な正確性が必要な場合は他の場所で引用数を確認してください。
どんな人に向いているか?
大量のPDFに向き合う大学院生
TLDR機能は、複雑なコンピューターサイエンスや生物学の論文から一文の要約を抽出し、研究が関連しているかどうかを確認するために抄録全体を読む必要をなくしてくれます。文献レビュー中に不要な情報を除外する時間を大幅に減らせます。
特定のアイデアの流れを追う博士課程の学生
影響力スコアは、序文で軽く触れられただけの引用ではなく、論文の方向性を実際に形作った引用を強調します。論文の「影響力」を知ることで、数十年にわたる概念の実際の進化を把握できます。ありふれた引用の海に迷い込むこともありません。
学術アプリを構築する開発者
オープンAPIは、旧来のデータベースのような制限なしに、論文のメタデータと引用関係の巨大なグラフに安定してアクセスできます。インデックス化されたデータセットを使って、独自の研究ツールやデータ可視化を構築できます。これこそ、オープンサイエンス分野で革新を起こすために必要な生データです。
情報過多に悩む若手研究者
パーソナライズされた研究フィードは、ライブラリフォルダに保存した内容に基づいて新しい論文を提案し、あなたのニッチを学習する発見エンジンのように機能します。AIのような急速に変化する分野での「毎朝の検索」を自動化し、重要な発見を見逃さないようにします。最新情報の追跡が、手作業ではなく裏で自動的に進むようになります。
共同研究ラボ
共有フォルダにより、チームは関連する資料をまとめ、引用を一括してエクスポートできるので、グループプロジェクト中も全員が同じ情報を共有できます。個人の発見とチームの知識管理の間のギャップを埋めます。「あの論文見た?」というメールのやり取りとはお別れです。
予算の限られた独立研究者
このプラットフォームは、STMおよび社会科学分野の2億件以上の論文への無料アクセスを提供し、高価な独自インデックスに代わる専門的な選択肢を提供します。大学が補助する契約なしで、高度なNLP機能を利用できます。高度な科学的発見ツールは、もはや資金力のある機関だけの特権ではありません。
Semantic Scholarの料金
ほとんどの学術検索エンジンは、最終的に最良の機能を有料の壁の裏に隠しますが、Semantic Scholarはオープンなままです。Allen Institute for AIが資金提供しているため、サブスクリプションなしで深い引用マッピングや論文要約にアクセスできます。
コアプラットフォームは全員に無料です。
標準的な研究には無料。パブリックエンドポイントは、認証されていない全ユーザーで毎秒1000リクエストのレート制限を共有します。
契約により利用可能。サイトには段階的な価格表は記載されていませんが、専用のスループット(毎秒1リクエストから)が必要な開発者はAPIキーを申請する必要があります。
オープン。ライセンス料を支払わずに、ローカル分析用の一括データセットをダウンロードできます。月額料金を気にせずに、独自の研究ツールやスクリプトを構築できます。APIは無料ですが、認証なしの利用枠はピーク時にスロットリングされることがあるので、プロジェクトのためにデータをスクレイピングする予定があれば無料のAPIキーを取得してください。
Semantic Scholarの主な機能
AI生成のTL;DRは、論文の主な貢献を一文で明確に示します
複数のタブを開かずに、数十件の検索結果をざっと見て核心となる論点を見つけることができます。これにより、研究が関連しているかどうかを確認するためだけに濃密な抄録を読む精神的疲労を防げます。最も関連性の高い一文を持つ論文を選んで、深く掘り下げていきましょう。
このエンジンは、論文が単に言及されているだけでなく、以前の研究を発展させているかどうかを識別することで、単純な引用数よりも影響力のある引用を優先します
あなたの分野で実際に流れを変えた研究がどれかを見ることができます。これにより、「背景雑音」を飛ばして、現在の手法を形作った基盤的な文献に集中できます。「Highly Influential Citations」フィルターを使って、本当に重要な論文を見つけましょう。
自動化された研究フィードは、あなたのライブラリの特定の技術的焦点に基づいて新しいプレプリントを提案します
広範なキーワードアラートではしばしば見逃されるニッチな論文を捉えてくれます。これにより、異なるジャーナルにわたる毎週の手作業検索を省くことができます。ソースを追加するたびに推薦がどのように進化するか、毎週ライブラリを確認しましょう。
Semantic Readerは、PDFを読んでいる最中に重要な用語や引用をその場でハイライトします
参考文献リストまでスクロールしなくても、定義や相互参照を表示してくれます。これにより、見慣れない略語や複雑な数式に遭遇したときの読書の流れを維持できます。他のページに移動せずに、引用にホバーして抄録を即座に確認しましょう。
このプラットフォームは、研究に関連するオープンアクセス版やGitHubリポジトリに直接リンクします
理論的な主張から実際の実装や生データまで、2クリックで移動できます。これにより、手法を読むことと実際に再現しようとすることの間のギャップを埋めます。「Code」ボタンを確認して、著者がスタックを公開しているか調べましょう。
著者ページは、数百万件のプロフィールにわたるキャリア全体の影響力と共同研究ネットワークを集約します
研究者の一貫性を評価し、ラボの成果をより広く見るために頻繁な共著者を見つけるのが簡単になります。これは、ある発見が単発のものか、継続的な研究プログラムの一部かについての文脈を提供します。主要著者をフォローして、異なる出版媒体にわたる今後の研究を追跡しましょう。
Semantic Scholarの長所と短所
長所
Semantic Scholarは、数百万本の論文に一文のTLDRを添えることで、学術的な言い回しを読み解く時間を大きく削ります。密度の高い抄録を読むためにタブを二十個開く代わりに、検索結果の一覧を眺めるだけで、自分の主張を実際に支える研究を見分けられます。「Highly Influential Citations」フィルターが通りすがりの言及をうまくふるい落とし、その分野の流れを本当に変えた研究だけを浮かび上がらせる点に気づきました。これが重要なのは、上辺だけの参照の上に文献リストを積み上げずに済むからです。コンピューターサイエンスや生物学の文献地図を素早く描く用途では快適ですが、人文学の細分野では収録に濃淡があります。引用する前に、引用文脈のスニペットを見て、その論文が支持されたのか反論されたのかを確かめましょう。
短所
ライブラリ機能は実用一点張りで、専用の文献管理ソフトにあるようなPDFへの本格的な注釈機能はありません。Research FeedsのAI推薦は的を外しませんが、主要コーパスに未収録の最新プレプリントを取りこぼすことがあります。速さの代償として、AI生成の要素が場所を奪い合うと、検索画面が雑然として見えます。また、探索ではなく特定の既知の論文を探しているときは、情報過多の画面が気を散らします。数千件のローカルファイルを一元管理したい研究者には向きません。文献整理の唯一のツールとしてではなく、論文を発見するためのレイヤーとして使いましょう。
こんな時にSemantic Scholarを使いましょう…
- 数百万本の論文に隠れたつながりを浮かび上がらせるAI
- キーワード照合に頼らない、真のセマンティック検索
- 読むべき論文リストを素早く絞り込める一文要約
- 研究インパクトを監視するための自動引用追跡
- データ駆動型のスマートなランキングによる、影響力のある論文の発見
- 最新の学術的ブレークスルーのパーソナライズされたフィード
- 主流になる前のトレンド研究テーマの把握
Semantic Scholarの代替ツール
Semantic Scholarのレビュー
文献検索ツールとしては最高です。AIによる要約が読む時間を数時間節約してくれます。
よくある質問
Semantic Scholarはどのように引用数を計算していますか?
Semantic Scholarは、そのコーパス内で利用可能なデータに基づいて引用元の論文を特定しますが、これは主に出版された学術論文とプレプリントに焦点を当てています。書籍のカバー範囲が限られており、特許は含まれていないため、引用数は他のサイトと異なる場合があります。
TLDR要約とは何ですか?
TLDRは人工知能を用いて生成された非常に短い要約で、論文の主な目的と結果を強調しています。研究者が自分の研究に関連するかどうかを素早く判断できるように、論文を素早く読み流すことを目的としています。
プラットフォーム上でH指数はどのように決定されますか?
H指数はSemantic Scholarのデータベース内で発見可能な引用データを使用して計算されます。h本の論文がそれぞれh回以上引用されているときの、hの最大値を表します。
「Highly Influential Citations(高影響度引用)」とは何ですか?
この機能は機械学習モデルを使用して、引用されている論文が引用元の論文に大きな影響を与えた箇所を特定します。研究者が大量の引用の中から最も意味のあるつながりを見つけるのに役立ちます。
研究論文を保存して整理することはできますか?
はい、無料アカウントを作成することで、論文を個人ライブラリに保存し、カスタマイズしたフォルダに整理し、それらのフォルダを共同研究者と共有することができます。
「Research Feeds(リサーチフィード)」とは何ですか?
Research Feedsは、あなたがライブラリフォルダに保存した項目に基づいて新しい論文を提案する、パーソナライズされたAI搭載のおすすめ機能です。おすすめされた論文の関連性を評価することで、システムがあなたの興味を学習していきます。
自分のSemantic Scholar IDはどうすれば見つけられますか?
サイト上で自分の著者ページを検索することでIDを見つけることができます。IDは、その著者ページのURLの末尾にある数字の文字列です。
開発者向けのツールはありますか?
Semantic ScholarはRESTful APIとSemantic Scholar Academic Graph(S2AG)データセットを提供しており、開発者は学術コンテンツや引用データを自分のアプリケーションに組み込むことができます。