
Ollama
UtvecklingsverktygUppdaterad 4 oktober 2026
Ollama är ett ramverk med öppen källkod för att köra stora språkmodeller lokalt på macOS, Windows och Linux med full integritet.
Vi kan få provision när du registrerar dig via våra länkar. Det påverkar inte våra recensioner.
Vad är Ollama?
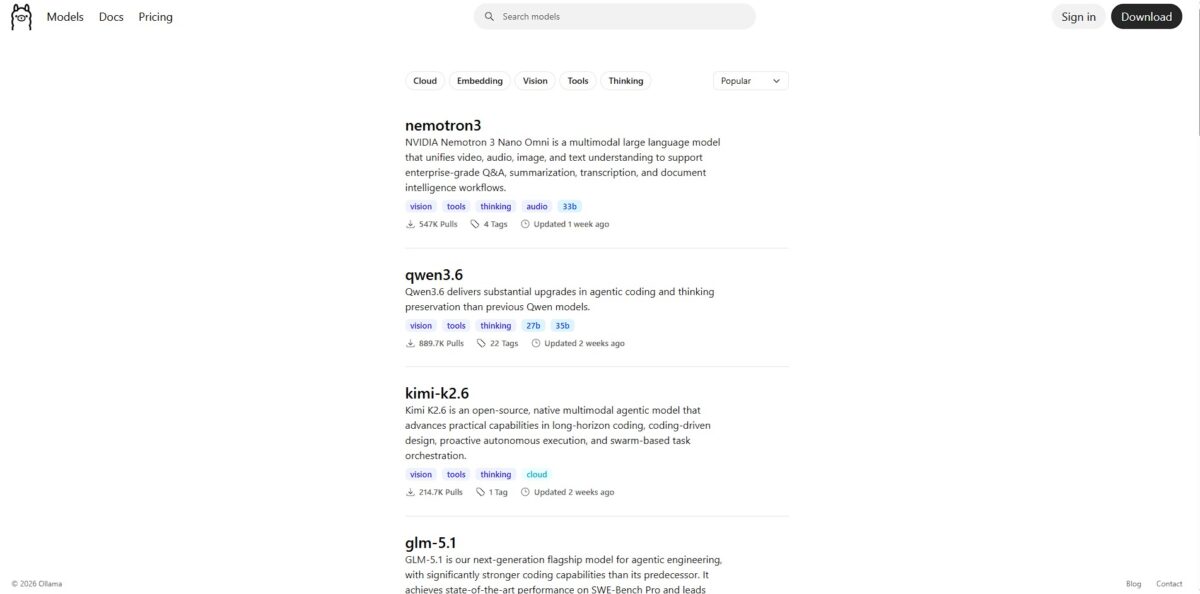
Ollama fungerar som en lättviktig bro som drar ut stora språkmodeller ur molnet och ner till din lokala hårdvara. Den paketerar modellvikter och konfigurationer i ett enda, portabelt format, vilket gör att du kan köra en privat instans av Llama 3 eller Mistral direkt från din terminal. Jag märkte att den hanterar minnesavlastning smart; om GPU:ns VRAM fylls upp flyttar den resten till ditt systemminne för att förhindra att genereringen kraschar. Det eliminerar fördröjningen från nätverksanrop och den återkommande kostnaden för API-tokens samtidigt som din data förblir strikt lokal. Det fungerar utmärkt för att bygga offline-kodassistenter eller bearbeta känsliga loggar, även om prestandan sjunker markant på maskiner utan ett dedikerat NVIDIA- eller Apple Silicon-chip. Välj Ollama om du har minst 16 GB RAM och värdesätter datasuveränitet mer än att använda de absolut största tillgängliga modellerna.
Hur börjar man använda Ollama?
Hämta installationsprogrammet för macOS eller Windows från den officiella webbplatsen. Linux-användare får ett enradigt curl-skript som sköter det tunga arbetet. Windows-installationen sätter automatiskt upp en bakgrundstjänst, vilket är praktiskt men kan förvåna dig om du är kräsen med startappar. Detta får motorn igång utan att du behöver röra en enda rad konfigurationskod, och du slipper sätta upp Python-miljöer bara för att prata med en AI.
Öppna din terminal och skriv ollama run llama3.2. Om det är första gången hämtar verktyget modellvikterna från registret. Du ser en förloppsindikator som faktiskt rör sig snabbt med en hyfsad uppkoppling. När det är klart får du en chevron-prompt redo för dina frågor. Det är ett snabbt sätt att testa en modells logik innan du satsar på att bygga en app runt den.
För en anpassad upplevelse skapar du en Modelfile i din projektmapp. Du kan baka in en systemprompt som ”Du är en senior Rust-utvecklare” så att du slipper upprepa dig varje session. Använd kommandot ollama create my-assistant -f Modelfile för att bygga din specialiserade variant. Detta förvandlar en generisk modell till ett fokuserat verktyg skräddarsytt för din specifika kodbas eller stil. Specialiserade prompter minskar också behovet av långa, repetitiva instruktioner i varje chatt.
Integration innebär vanligtvis att peka din IDE eller lokala webb-UI mot localhost:11434. De flesta verktyg som Cursor eller AnythingLLM har numera ett särskilt reglage för Ollama. Jag märkte att om du har en NVIDIA-GPU är hastighetsskillnaden som natt och dag jämfört med ren CPU-inferens. Det fungerar bra för privat utkastskrivning, men förvänta dig att fläktarna sätter igång under långa genereringsuppgifter.
Vem passar det för?
Integritetsförespråkaren
Om du hanterar proprietär logik eller klientloggar är det en risk att skicka data till ett moln-API. Ollama håller varje token på din lokala disk, så din kod lämnar aldrig din brandvägg. Det är viktigt eftersom det eliminerar risken att känslig data läcker in i en offentlig modells träningsdata.
Utvecklaren som ogillar Python
Många lokala LLM-verktyg kräver att man hanterar komplexa virtuella miljöer eller specifika CUDA-versioner. Ollama är en enda binärfil som sköter installationen åt dig. Du kan fokusera på att bygga din app istället för att felsöka beroendehelvetet.
Offline-utforskare
Om du arbetar från en avlägsen forskningsstation, ett flygplan eller ett landsbygdsområde med dålig täckning är moln-AI värdelös. När du väl har hämtat modellvikterna har du en fullt fungerande assistent utan internetanslutning. Det fungerar till och med när min laptop är i flygplansläge utan någon fördröjning, så din produktivitet är inte knuten till en Wi-Fi-signal.
Avancerade hårdvaruanvändare
Om du investerat i en högklassig Mac eller en NVIDIA-GPU har du outnyttjad beräkningskraft som ligger stilla. Ollama utnyttjar din hårdvara för att generera text i hastigheter som konkurrerar med betalda API:er, och din hårdvaruinvestering förvandlas till en återkommande kostnadsbesparing. Nackdelen är att det kommer att tömma ditt batteri och sätta igång dina fläktar vid intensiv användning.
Snabba prototypare
Att växla mellan Llama 3, Mistral och specialiserade kodningsmodeller tar ett enda terminalkommando. Du kan testa hur olika arkitekturer hanterar dina specifika prompter på sekunder istället för minuter. Det snabbar upp återkopplingsloopen när du väljer rätt modell för en nischad uppgift.
Budgetmedvetna byggare
Återkommande månadsprenumerationer och avgifter per token blir dyra när du felsöker eller experimenterar. Lokal inferens är gratis när du väl äger hårdvaran, vilket möjliggör oändliga iterationer utan faktura. Det kostar inget att ”misslyckas snabbt” medan du lär dig.
Priser för Ollama
Ollama fungerar enligt en modell som gynnar den lokala byggaren framför molnprenumeranten. Du laddar ner ramverket gratis och kör modeller med öppen källkod på din egen hårdvara utan återkommande månadsavgifter eller avgifter per token. Detta upplägg flyttar den finansiella bördan från mjukvaruprenumerationer till din elräkning och GPU-uppgraderingar. Även om själva mjukvaran är gratis är den dolda kostnaden hårdvaran som krävs för att en 70B-parametermodell inte ska krypa fram i tre tokens per sekund.
Du får CLI:t och skrivbordsappen för macOS, Linux och Windows helt gratis. Detta tar bort hindret för utvecklare som prototypar privata verktyg och vill undvika överraskande API-fakturor i slutet av månaden. Du kan experimentera hur mycket du vill utan att registrera något kreditkort.
Dessa betalalternativ finns för användare som behöver avlasta massiva modeller till fjärr-GPU:er när det lokala VRAM-utrymmet når ett hårt tak. Det ger ett sätt att köra tunga resonemangsmodeller utan att äga ett serverrack för trettiotusen dollar. För små 7B-modeller är dock den kostnadsfria lokala vägen nästan alltid det smartare valet. Du betalar bara när din lokala hårdvara fysiskt inte klarar av den modellstorlek du behöver.
Viktigaste funktionerna i Ollama
Kör modeller med öppen källkod som Llama 3 eller Mistral direkt på din hårdvara
Du slutar skicka privata kodsnuttar till externa API:er, och håller känslig logik innanför din brandvägg. Inga fler läckor av känslig data under utvecklingen.
Paketera modellvikter och konfigurationer i en enda ”Modelfile”
Du definierar specifika systemprompter eller parametrar en gång och delar dem med ditt team för enhetliga resultat. Det är viktigt eftersom det förhindrar huvudvärken med promptutveckling av typen ”det fungerade på min maskin”.
Kom åt dina lokala modeller via ett inbyggt REST-API
Du kan koppla ihop dina egna Python-skript eller webbappar utan komplex orkestrering eller dyra tokenkostnader. Du kan prototypa AI-funktioner gratis innan du binder dig till en molnleverantör.
Växla mellan olika modeller med ett enda terminalkommando
Övergången mellan en 7B-parametermodell för chatt och en specialiserad kodningsmodell sker på sekunder. Avvägningen är att större modeller kommer att krypa fram om du saknar en dedikerad GPU. Ändå låter det dig välja rätt verktyg för den specifika uppgiften.
Hantera GPU-acceleration automatiskt på macOS, Linux och Windows
Ollama identifierar din hårdvara och flyttar över så mycket som möjligt till grafikkortet utan manuellt pillande med drivrutiner. Du får snabbare inferens utan att behöva bli systemadministratör.
För- och nackdelar med Ollama
Fördelar
Ollama kokar ner lokal driftsättning av en modell till ett enda kommando. Du slipper mardrömmen med att ställa in CUDA-drivrutiner eller jaga passande binärfiler på GitHub. Den kör modellerna helt på din egen dator, så att företagets kod aldrig lämnar nätverket. Därmed försvinner också risker för dataskyddet och löpande kostnader för API-prenumerationer. Det tar sekunder att växla mellan Llama 3 och Mistral, vilket gör det enkelt att pröva vilken arkitektur som klarar just dina prompter bäst. Använd den för att bygga och finslipa AI-appar utan internetuppkoppling.
Nackdelar
Hårdvaran är fortfarande den yttersta flaskhalsen. Att köra en modell med 70B parametrar på en vanlig laptop ger en plågsam takt på ett token i minuten. Du behöver rejält med VRAM för de tvåsiffriga hastigheter ett flytande samtal kräver. Vanliga modeller går bra, men egna finjusterade varianter kräver mer handarbete att importera än på molnplattformar. Du avstår också från det avancerade resonemanget hos väldiga modeller som GPT-4o, och komplex logik i flera steg kan fallera på de mindre modeller din hårdvara faktiskt orkar med.
Använd Ollama om du vill…
- Köra modeller med öppna vikter helt på din egen hårdvara.
- Hålla känslig data och prompter strikt privata.
- Undvika återkommande månatliga API-prenumerationer och användningsavgifter.
- Experimentera med LLM:er utan en aktiv internetanslutning.
- Integrera lokal AI i anpassade utvecklingsflöden via API.
- Testa olika modellkvantiseringar för hastighet och noggrannhet.
- Eliminera molnlatens för omedelbar tokengenerering på enheten.
- Behålla full kontroll över modellversioner och driftsättningar.
Alternativ till Ollama
Recensioner av Ollama
Ollama ger dig tillgång till stora modeller med öppen källkod i molnet till en bråkdel av kostnaden, vilket gör det enkelt att testa modeller som DeepSeek och Qwen.
Det är lagret som låter en dokumentärklippare köra Gemma på sin egen laptop utan att behöva hantera Python-miljöer eller konfigurationsfiler. Massiv infrastruktur för AI som körs lokalt.
Vi använder det för att köra LLM:er lokalt för snabbare iteration och noll latens. Det är som att ha vårt eget AI-labb minus de enorma GPU-kostnaderna.
Att ha detta på en lång flygresa hjälpte mig att prototypa produktändringar utan att förlita mig på instabilt wifi ombord. Dataskyddet är en stor fördel.
Mycket enkelt och kraftfullt att köra och anpassa lokala LLM:er. Integrationen med LangChain och LlamaIndex är okomplicerad och tillförlitlig.
Vanliga frågor
Kräver Ollama en internetanslutning?
Du behöver en internetanslutning för att ladda ner Ollama-installationsprogrammet och de första modellfilerna. När modellerna väl är lagrade på din dator kan du köra och interagera med dem helt offline.
Hur hanterar Ollama min datasekretess?
Ollama kör modeller lokalt på din hårdvara, vilket innebär att dina prompter och modellernas svar aldrig lämnar din dator eller skickas till en molnserver för bearbetning.
Vilka är hårdvarukraven för att köra stora modeller?
Modellens prestanda beror till stor del på RAM och VRAM. Små modeller behöver vanligtvis minst 8 GB RAM, medan större modeller som 70B-varianterna vanligtvis kräver 32 GB eller mer och en kompatibel GPU för acceptabel hastighet.
Kan jag köra flera modeller samtidigt?
Ja, Ollama stöder att ladda flera modeller samtidigt om ditt system har tillräckligt med tillgängligt minne. Du kan justera det maximala antalet laddade modeller med miljövariabeln OLLAMA_MAX_LOADED_MODELS.
Hur uppdaterar jag modellerna jag har laddat ner?
Du kan uppdatera en modell till den senaste versionen genom att köra kommandot ollama pull följt av modellens namn. Detta laddar ner eventuella nya vikter eller konfigurationer som finns tillgängliga i Ollama-biblioteket.
Vad är kvantisering och varför spelar det roll?
Kvantisering komprimerar stora modeller så att de får plats på vanlig konsumenthårdvara genom att minska precisionen hos deras vikter. Det gör att du kan köra kraftfulla modeller med mindre minne, även om det kan påverka svarens noggrannhet något.
Liknande verktyg
 Devin DesktopDevin Desktop (tidigare Windsurf) är Cognitions agentbaserade AI-IDE som kombinerar djup förståelse för kodbaser med lokala och molnbaserade kodningsagenter som styrs från
 QoderQoder är en agentbaserad AI-kodningsplattform som automatiserar komplexa arbetsflöden med autonoma agenter och djup insikt i kodbasen.
 ReplitReplit är en samarbetsinriktad, webbläsarbaserad IDE med integrerade AI-verktyg för smidig kodning, snabb driftsättning och samtidig redigering i realtid.