
RunPod
UtvecklingsverktygUppdaterad 4 oktober 2026
RunPod är en skalbar molnplattform som tillhandahåller GPU-resurser på begäran samt serverlösa slutpunkter för träning och inferens av AI-modeller.
Vi kan få provision när du registrerar dig via våra länkar. Det påverkar inte våra recensioner.
Vad är RunPod?
RunPod fungerar som en globalt distribuerad GPU-marknadsplats där du kan hyra kraftfull datorkraft per timme för att starta Stable Diffusion-instanser eller träna LLM:er – helt utan krånglet med företagsavtal i molnet. Det kringgår bristen på lokal hårdvara genom att koppla samman dig med ett nätverk av privata leverantörer och datacenteroperatörer, så att du kan driftsätta Docker-containrar på RTX 3090 eller A100 inom sekunder. Jag noterade att gränssnittet är byggt för snabbhet, även om spot-instansmarknaden innebär att din pod kan försvinna om någon annan bjuder högre. Detta är viktigt eftersom det drastiskt sänker kostnaderna för AI-experiment jämfört med hyperscalers med fasta priser. Använd community-hanterade mallar för en snabb start, men växla till dedikerade instanser om din träningskörning inte tål avbrott.
Hur börjar man använda RunPod?
Börja med att registrera dig på RunPod-konsolen och verifiera din e-postadress. Du behöver fylla på saldo direkt eftersom plattformen använder en förbetald modell. Minimiinsättningen är låg, vilket är perfekt för att testa ett enda RTX 4090 utan större åtaganden. Att hyra kraftfull datorkraft per timme istället för att köpa en arbetsstation för ett femsiffrigt belopp sänker tröskeln för att träna nischmodeller eller köra beräkningsintensiv inferens. Tips: Aktivera tvåfaktorsautentisering direkt för att skydda ditt saldo.
Bläddra sedan i avsnitten “GPU Cloud” eller “Serverless” för att välja din hårdvara. Du kan välja specifika grafikkort som A100 eller billigare, community-tillhandahållna instanser. Varje “pod” kräver en mall; den officiella PyTorch-mallen fungerar vanligtvis bäst för AI-arbetsbelastningar. Detta undviker mardrömmen med manuell installation av CUDA-drivrutiner. Förkonfigurerade miljöer låter dig börja koda inom minuter istället för att felsöka kärninkompatibiliteter, även om community-poddar kan vara mindre pålitliga än de från säkra datacenter.
Slutsats: Kontrollera VRAM-kraven innan driftsättning för att undvika minnesfel på mindre grafikkort.Starta din pod och vänta ungefär sextio sekunder på att containern ska initialiseras. Du kan ansluta via en webbaserad Jupyter Lab eller använda SSH för lokal IDE-integration. Jag föredrar SSH-vägen eftersom det låter mig använda VS Code-tillägg direkt på den fjärranslutna GPU:n. Detta förvandlar en vanlig bärbar dator till en specialiserad AI-maskin, som kombinerar den lokala redigeringens responsivitet med den råa kraften hos en fjärransluten H100 och en professionell terminal för komplexa skript.
Slutsats: Spara din publika SSH-nyckel i RunPod-inställningarna för att slippa lösenordsfrågan vid varje anslutning.Hantera slutligen dina data med hjälp av nätverksvolymer om du vill behålla dina datamängder mellan olika sessioner. Vanligt pod-lagringsutrymme är flyktigt, så allt som inte finns i en volym försvinner när du avslutar instansen. Denna konfiguration skyddar dina vikter och loggar även om du byter från en billig GPU för felsökning till en kraftfull GPU för träning. Du betalar en liten löpande kostnad för själva lagringen, men beständiga volymer frikopplar din dyra datorkraft från dina värdefulla data, så en vanlig avstängning kan inte radera dagar av träningsframsteg.
Slutsats: Sätt alltid en pod på “Stop” för att spara pengar samtidigt som data bevaras, men “Terminate” den inte förrän du är helt klar.
Vem passar det för?
Den oberoende forskaren.
Du behöver kraftfullt NVIDIA-VRAM för att träna en anpassad LoRA eller finjustera en LLM utan att betala det femsiffriga priset för en personlig arbetsstation. Genom att hyra ett A100 per timme kan du testa hypoteser på hårdvara som annars vore otillgänglig. För enskilda experimenterare som konkurrerar med riskkapitalfinansierade laboratorier skapar det lika villkor.
Inferensingenjören
Du vill hosta ett API för en generativ AI-app som bara kostar pengar när någon faktiskt anropar slutpunkten. Serverlösa GPU:er startar containrar under trafiktoppar och skalar tillbaka till noll under lugna perioder. Din molnräkning slutar äta upp dina marginaler medan din app står stilla. Jag noterade att FlashBoot-tekniken minskar kallstarter till bara några sekunder, vilket gör det praktiskt för realtidsappar.
Den avancerade Docker-användaren
Om din miljö redan är containeriserad kan du driftsätta din specifika stack på en fjärransluten GPU på ungefär sextio sekunder. Detta kringgår “beroendehelvetet” med manuell installation av CUDA-drivrutiner på lokala Linux-distributioner. Du ägnar din tid åt att skriva Python istället för att felsöka kärninkompatibiliteter. Nackdelen är att du måste vara disciplinerad med nätverksvolymer för att lagra data permanent.
VS Code-utvecklaren
Du föredrar din lokala IDE men behöver den råa kraften hos ett fjärranslutet H100-kluster. Genom att ansluta via SSH förvandlas din vanliga bärbara dator till en specialiserad AI-maskin med full terminalåtkomst och stöd för tillägg. Du kombinerar lokal responsivitet med prestandan hos ett datacenter. Jag har märkt att man slipper upprepade lösenordsfrågor om man sätter upp publika SSH-nycklar tidigt.
Stable Diffusion-hobbyisten
Du vill generera hela batcher av högupplösta bilder med ComfyUI eller Automatic1111 utan att belasta din GPU hemma. Med förkonfigurerade mallar kan du starta ett webbgränssnitt på ett RTX 4090 inom några minuter. Komplexa arbetsflöden som ControlNet eller IP-Adapter itererar mycket snabbare. Det passar bra för intensiva kreativa sessioner, men är mindre idealiskt för tillfälliga enstaka bildprompter.
Priser för RunPod
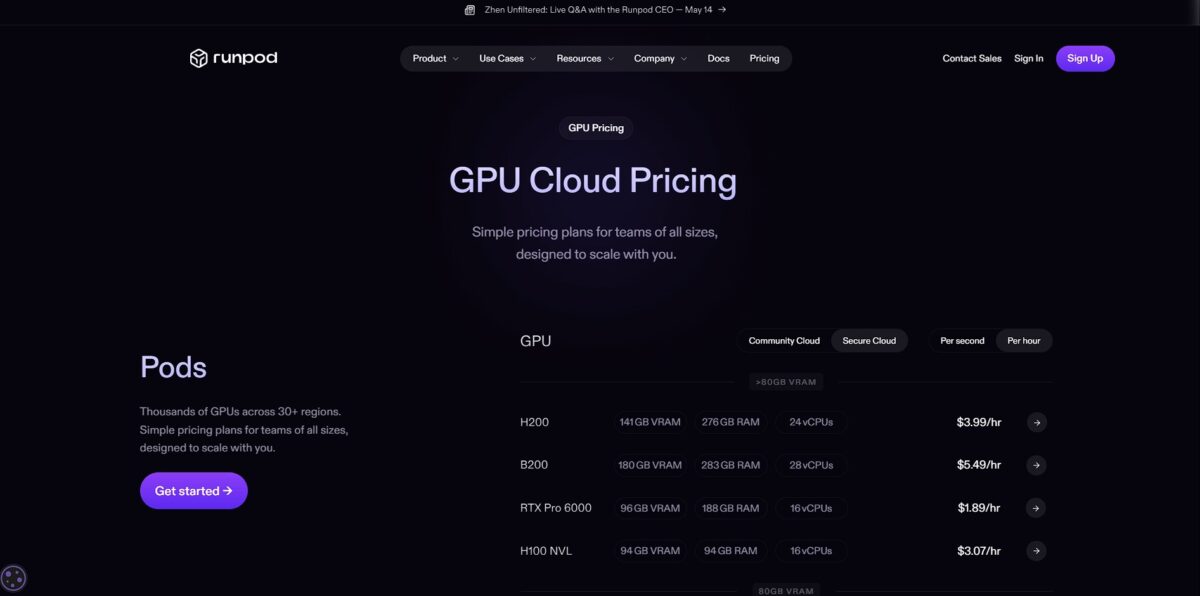
RunPod avstår från den fasta månadsprenumerationen till förmån för en marknadsplatsbaserad modell där du hyr GPU-tid per sekund eller per timme. Upplägget ger dig tillgång till kraftfull hårdvara som H100 eller A100 utan de stora påslag som traditionella molnleverantörer tar. Du betalar exakt för det du förbrukar, så oanvända instanser slösar inte pengar under långa träningspauser. Nackdelen är prisvolatilitet; kostnaderna fluktuerar beroende på aktuell nätverksefterfrågan och vilken prisnivå du väljer.
Secure Cloud-instanser börjar på cirka 0,44 $/tim för ett RTX 4090, medan priserna för Community Cloud-alternativ för samma chip kan sjunka till 0,34 $/tim. Dessa poddar förblir dina tills du raderar dem, vilket ger en stabil miljö för komplext utvecklingsarbete utan risk för plötslig avstängning.
Du betalar bara när din kod faktiskt körs, vilket passar inferens-API:er som skalar till noll så snart trafiken avtar.
Beräkningskostnaderna sjunker, men lagringen förblir en separat, fast kostnad. Ändå hjälper förutsägbar fakturering team att budgetera för långsiktig hosting av modeller.
Räkna med 0,10 $/GB/månad för aktiva volymdiskar.
En viktig “hake” är att stoppade poddar debiteras dubbel taxa (0,20 $/GB/månad) för lagringsutrymme, för att förhindra hamstring av oanvända resurser. Policyn tvingar fram disciplinerad datahantering.
Viktigaste funktionerna i RunPod
Hyr kraftfulla GPU:er av typen NVIDIA H100 eller A100 per sekund
Du undviker massiva investeringskostnader eftersom du bara betalar för de beräkningscykler som din modellträning faktiskt förbrukar. Ensamforskare som inte har råd med ett hårdvarurack för 40 000 $ får tillgång till samma klass av hårdvara.
Starta serverlösa slutpunkter som skalar ner till noll när de är inaktiva
Ditt API förblir responsivt vid trafiktoppar men slutar generera kostnader i samma stund som förfrågningarna upphör. Inga fler chockfakturor från outnyttjad datorkraft i datacentret.
Driftsätt anpassade Docker-containrar eller använd förkonfigurerade mallar för PyTorch och Jupyter
Du slipper “beroendehelvetet” med att installera CUDA-drivrutiner och kan börja direkt i din notebook. Det kortar tiden mellan en idé och ett körbart benchmark med flera timmar.
Koppla beständig nätverkslagring till flera poddar
Dina träningscheckpoints och stora dataset förblir tillgängliga även när du byter GPU-typ eller startar om en pod. Detta är viktigt eftersom du inte förlorar flera dagars arbete när en spot-instans frigörs.
Välj Community Cloud för lägre priser eller Secure Cloud för krav på regelefterlevnad
Du väljer mellan maximala besparingar på ledig kapacitet och dedikerad hårdvara för känslig data. Du styr själv avvägningen mellan pris och integritet.
Använd Flash CLI för att skicka Python-funktioner direkt till molnet
Du slipper bygga och hantera avbildningar eftersom plattformen sköter orkestreringen. Du kan fokusera på applikationslogiken i stället för infrastrukturen.
För- och nackdelar med RunPod
Fördelar
RunPod tillhandahåller GPU:er när hyperscalers visar felmeddelanden om att kapaciteten är slut. Du slipper säljsamtal och väntan på att kvoter ska godkännas. Starta en H100 eller en RTX 4090 på under en minut. Sekundbaserad debitering gör att du slutar betala i samma ögonblick som ditt skript är klart. De serverlösa slutpunkterna skalar ner till noll, vilket eliminerar kostnader för inaktiv tid: du betalar bara för aktiv datorkraft. Använd Secure Cloud för stabilitet och Community Cloud för maximala besparingar.
Nackdelar
Marknadsplatsmodellen innebär kompromisser när det gäller stabilitet. Community-instanser ger stora rabatter men kan plötsligt avbrytas. Ditt träningsjobb kan avbrytas om någon bjuder över dig, så beständiga lagringsvolymer behövs för täta checkpoints. Plattformen saknar det breda tjänsteekosystem som finns hos AWS eller Google Cloud. Hanterade SQL-databaser eller nätverkslösningar för företag hittar du inte här. Montera alltid en nätverksvolym för att skydda din data mot oväntade avstängningar av poddar.
Använd RunPod om du vill…
- Hyra kraftfulla GPU:er för AI-träning med sekundbaserad debitering.
- Driftsätta serverlösa inferensslutpunkter utan att hantera infrastruktur.
- Få omedelbar tillgång till H100- eller A100-kluster för stora modeller.
- Köra beständiga poddar med full root- och SSH-åtkomst.
- Skala AI-arbetsbelastningar i produktion enkelt globalt.
- Finjustera LLM:er med hjälp av kostnadseffektiv, community-tillhandahållen datorkraft.
- Övervaka GPU-temperatur och minnesanvändning direkt i realtid.
- Undvika komplexa molnavtal tack vare transparent sekundbaserad debitering.
Alternativ till RunPod
Recensioner av RunPod
Utmärkt för AI-utveckling. Att arbeta i en CUDA- och GPU-stödd arbetsmiljö är mycket viktigt, och RunPod erbjuder detta med enkel installation.
Fantastiskt användargränssnitt och omedelbart tillgängliga GPU:er. För en molnhosting-tjänst i mellanprisklassen är detta det bästa valet.
Enkelt att använda och bästa kvalitet för detta pris. Även supporten är relativt smidig jämfört med de stora leverantörerna.
Utmärkt lämpad för startups. Den är verkligen flexibel och enkel att använda. Man kan enkelt driftsätta färdiga mallar och komma igång direkt.
Vanliga frågor
Vad är skillnaden mellan Secure Cloud och Community Cloud?
Secure Cloud körs i högteknologiska datacenter med tillförlitlighet och säkerhet i företagsklass, medan Community Cloud använder ett peer-to-peer-nätverk av enskilda GPU-leverantörer. Secure Cloud passar bättre för produktionsarbetsbelastningar och känsliga data, medan Community Cloud erbjuder betydligt lägre priser för icke-kritisk utveckling och testning.
Hur fungerar beständig lagring?
Med RunPod kan du skapa nätverksvolymer som kan kopplas till dina poddar. Dessa volymer säkerställer att dina data, modeller och kod förblir tillgängliga även efter att en pod avslutats eller startats om, och du betalar bara för det lagringsutrymme du faktiskt använder.
Vad är spot-instanser?
Spot-instanser är tillgängliga till ett betydande prisavdrag jämfört med prissättning på begäran. Nackdelen är att de kan avslutas i förtid om en on-demand-användare behöver kapaciteten. Därför passar de utmärkt för feltoleranta träningsjobb, men är mindre lämpade för beständiga webbtjänster.
Kan jag använda anpassade Docker-avbildningar?
Ja, du kan driftsätta poddar med valfria offentliga eller privata Docker-avbildningar från register som Docker Hub eller GitHub Container Registry. Detta gör att du kan förkonfigurera din miljö med specifika drivrutiner, bibliotek eller applikationskod.
Stöder RunPod serverlös driftsättning?
Ja, med RunPod Serverless kan du driftsätta AI-modeller som slutpunkter som skalas till noll vid inaktivitet. Du betalar bara för exakt den GPU-tid som krävs för att bearbeta varje begäran, vilket är extremt kostnadseffektivt för inferensuppgifter med varierande trafik.
Hur hanterar jag multi-GPU-kluster?
RunPod erbjuder Instant Clusters, med vilka du kan driftsätta flera noder med höghastighetsanslutningar. Detta är utformat för distribuerad träning av storskaliga modeller där en enskild GPU:s minne inte räcker till.
Liknande verktyg
 Devin DesktopDevin Desktop (tidigare Windsurf) är Cognitions agentbaserade AI-IDE som kombinerar djup förståelse för kodbaser med lokala och molnbaserade kodningsagenter som styrs från
 QoderQoder är en agentbaserad AI-kodningsplattform som automatiserar komplexa arbetsflöden med autonoma agenter och djup insikt i kodbasen.
 ReplitReplit är en samarbetsinriktad, webbläsarbaserad IDE med integrerade AI-verktyg för smidig kodning, snabb driftsättning och samtidig redigering i realtid.