Apify
数据分析更新于 2026年10月4日
Apify是一个功能强大的网页抓取和自动化平台,可使用预构建或自定义的actor来提取结构化数据。
通过我们的链接注册时,我们可能会获得佣金。这不会影响我们的评测。
什么是 Apify?
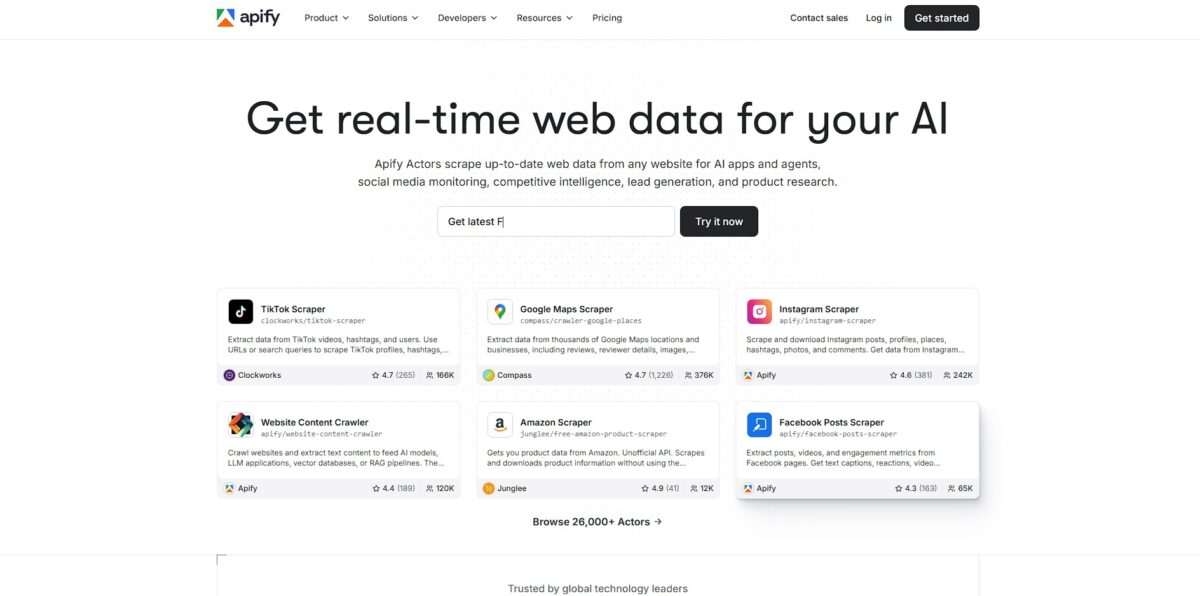
Apify 是一个用于运行“Actor”的云运行时,Actor 是容器化脚本,专门用于将网站转化为结构化数据或自动执行基于浏览器的任务。你可以部署自己的 Python 或 JavaScript 爬虫,也可以从他们商店中提供的 20,000 个预构建爬虫中挑选一个,用来采集 LinkedIn 潜在客户或亚马逊价格数据,而无需搭建任何服务器。它处理了网络抓取中繁琐的部分,比如轮换住宅代理和绕过验证码,这样你就不用每次网站布局改变时都重写逻辑。虽然它主要面向想要避免基础设施管理的开发者,但也提供了足够多的低代码模板,让非程序员也能把数据提取到电子表格中。实际上,这能把数小时的手动点击工作转化为一个可按计划运行的 API 端点。建议先查看商店,看看是否已有人解决了你的目标网站的抓取问题,再考虑从零开始搭建。
如何开始使用 Apify?
前往 Apify Console 并创建账户。你可以先浏览商店,那里有数以千计的针对 Instagram、Google 地图或亚马逊等网站的预构建爬虫。当你只需要快速获取产品价格的 CSV 文件时,选择现有工具可以省去编写代码的麻烦。你可以在几分钟内测试一个工作流,而无需搭建本地环境。
如果现成的 Actor 不合适,你会需要用到 Apify CLI。通过 NPM 安装它,从你的电脑上构建和部署自定义爬虫。它使用 Crawlee,这是他们的开源库,可以自动处理浏览器指纹和代理轮换。我注意到这正是学习曲线变陡的地方,因为你需要具备基本的 JavaScript 或 Python 知识,才能自定义爬虫如何与复杂菜单或无限滚动页面交互。Crawlee 还能防止你的爬虫被反机器人保护机制立即封锁。
一旦代码上线,在控制台中配置你的运行环境设置。你可以在这里设置内存限制并选择代理组。更高的内存有助于运行较重的无头浏览器,但会更快地消耗你的使用额度。这里的取舍在于速度与成本,所以建议先从小规模开始,只有在爬虫崩溃时才逐步扩大规模。这让你能够精细地控制计算预算。
最后,把你的数据连接到你其余的技术栈中。你可以设置 Webhook,在运行完成的那一刻触发 Slack 通知或将 JSON 结果发送到数据库。这比每天早上手动下载文件更可靠。这很重要,因为它能把一次性脚本变成一个无需人工干预的数据管道。
建议先从预构建的商店 Actor 入手,理解平台的运作逻辑,之后再尝试部署你自己的自定义代码。
适合哪些人?
Node.js 和 Python 开发者
使用 Crawlee 或 Apify SDK 构建和托管爬虫,无需管理自己的服务器基础设施或代理轮换。该平台自动处理了诸如有界面浏览器的扩容和指纹伪装等烦人的部分。这能让你免于“在我电脑上能跑,但生产环境不行”的困扰。
AI 工程师和 LLM 开发者
从复杂网站中提取干净的文本,为 RAG 管道提供数据或训练自定义模型。你得到的是现成的 Markdown 格式数据,而不是一堆混乱的 HTML 标签和脚本。这能防止你的 token 成本因无用的结构噪音而爆炸式增长。
增长黑客和潜在客户开发专家
从 LinkedIn、Google 地图或 Instagram 中提取潜在客户名单到电子表格中,无需编写一行代码。这避免了对官方 API 的依赖,而官方 API 通常有严格的速率限制或隐藏成本。你还能找到基本搜索中并不总是可见的联系方式。
电商和市场研究人员
实时监控亚马逊或 Shopify 上竞争对手的价格和库存水平,以调整自己的策略。该平台会轮换住宅代理,让你不会在发出一百个请求后就被封锁。我见过这种方法用于跟踪波动性较大的每日折扣。
开源贡献者
在商店发布你自己的自定义爬虫,当他人使用时可获得被动收入。Apify 负责计费和基础设施,你只需专注于代码逻辑。这是将专业抓取技能变现的一个小众方式。
SEO 专业人士
使用本地化代理跟踪不同地理位置的搜索排名和SERP 特性。你可以准确看到巴黎或东京的用户所看到的内容,而无需离开办公桌。这有助于弄清为什么你的全球流量可能在特定地区出现下滑。
Apify 定价
Apify 的定价采用混合模式,将固定的月度套餐与按使用量计费相结合。你选择一个基础套餐,获得相应功能和预付额度,一旦额度用完,就按实际使用量付费。这有点像爬虫版的预付费手机套餐,你可以充值,也可以在下一次账单中为超出部分付费。
Free:每月 0 美元。你可获得每月 5 美元的额度和 8GB 内存。适合用来试验或定期运行不会遇到严格反抓取机制的小型脚本。你只能获得社区支持,如果你的 Actor 在周五晚上出问题,响应可能会很慢。
Starter:每月 49 美元(部分地区为 39 美元)。这会将你的内存提升到 32GB,并包含 49 美元的平台额度。你可以获得邮件和聊天支持,这在目标网站更改 HTML 结构导致爬虫开始返回空值时非常重要。这个套餐能防止你在稍微超出限额时账户立即被锁定。
Scale:每月 199 美元。包含 199 美元的额度和 128GB 内存。在这个级别,你可以使用 100 个共享代理并获得优先支持。它能处理会让较小实例崩溃的大规模爬取任务,是生产级数据管道的合适选择。
Business:每月 999 美元。你可获得 999 美元的额度和一位专属客户经理。此套餐包含个人技术培训课程,帮助你优化代码。低效的代码会比预期更快地消耗额度。
Enterprise:定制定价。这取消了额度和数据保留方面的所有上限。它专为需要有保障的 SLA 和定制基础设施的大型组织而设计。
Apify 商店费用:一些预构建的爬虫(Actor)会收取自己的费用。你可能会看到固定的月租费或在平台使用费之外按结果计费。请注意,住宅代理是单独收费的(每 GB 7-8 美元),如果你在抓取有严格机器人检测的网站,这可能会让你感到意外。
Apify 主要功能
开箱即用的 Actor,立刻上手抓取
从数千个现成的抓取器中挑选,覆盖 Instagram、Google 地图、亚马逊等站点。当你只是想要一份商品价格或评论的 CSV 时,就不必再自己写代码。你可以在几分钟内开始取数,而不是花上几天做开发。
用 Crawlee 库做稳妥的爬取
这个开源库会自动处理代理轮换、指纹伪装和浏览器管理,让你的抓取器看起来更像真人,从而避开现代的反爬防护。因此,你的脚本不会再动辄因为 IP 封禁或复杂的反机器人拦截而中断。
自适应的 Playwright 爬虫
这个功能会根据页面的实际需要,在轻量快速的 HTTP 请求与完整的浏览器渲染之间自动切换。简单页面走速度优先,重度依赖 JavaScript 的站点则动用 Playwright 的全部能力。你既省下了算力开销和时间,又不会失去抓取复杂动态网站的能力。
无服务器的微应用托管
把你的抓取器作为“Actor”部署到 Apify 的云端基础设施上,自带存储与定时调度。你不必再操心自建服务器,也不用担心硬件扩容。你得到一个稳定的环境,抓取器可以 24/7 运行而无需干预。
智能代理管理。接入庞大的住宅与机房代理池,可按请求或按会话轮换
我注意到,这能有效绕开速率限制(429 错误)和地域限制。结果是,它让大规模的数据抓取任务保持很高的成功率。
统一的数据存储与导出
把结果直接存进数据集,随后导出为 JSON、CSV 或 Excel。你也可以通过 webhook 或 API 把这些数据喂给其他工具。它把从原始网页内容到可用业务数据的链路简化了。
Apify 优缺点
优点
Apify 把代理轮换和浏览器指纹这些繁重的活儿都接了过去,让你能从平时会拦截机器人的站点上抓取数据。你不必维护本地服务器,也不用跟封 IP 较劲,因为代码是在专门的云环境里跑的。商店里有数千个面向 Instagram、Google 地图等平台的现成脚本,不写代码也能在几分钟内开始提取结构化数据。你的注意力从维护基础设施转到了真正的数据分析上。如果你是开发者,用 SDK 可以完全掌控有界面浏览器的扩容。先用现成的 Actor,能省下开发时间。
缺点
平台采用的额度计费体系比较复杂,一旦目标站点改版、导致抓取脚本运行时间变长,月度账单就会难以预估。界面虽然清爽,但对不熟悉 JavaScript 或 Python 的人来说学习门槛不低。Free 套餐限制算力,处理大规模数据集就得尽快转到付费方案。省去自建服务器的代价,是单次执行成本高于本地跑脚本。这一点很重要,因为一个小小的代码错误可能在你发现问题之前就把预付额度耗光。每天查看 Actor 的用量日志,以免出现意外超支。
如果你想要以下功能,请使用 Apify……
- 无需自行管理服务器基础设施即可扩展网页抓取规模。
- 将任何网站转化为结构化、机器可读的数据集。
- 使用预构建的云端Actor自动执行基于浏览器的任务。
- 通过可靠的智能代理轮换绕过反爬虫防护。
- 将实时网络数据直接输入到你的AI模型中。
- 在你睡觉时也能按计划自动运行数据提取任务。
- 轻松部署用JavaScript或Python编写的自定义爬虫。
- 访问数千个针对热门平台的专业爬虫。
Apify 替代方案
Apify 用户评价
商店中丰富的预构建Actor为潜在客户开发节省了大量时间;它将数小时的定制编码工作变成了只需点击几下即可完成的操作。
这是我们找到的最完整、最可靠的抓取解决方案,不过基于额度的定价方式在长时间运行时可能难以预测。
该平台让自动化重复性网络任务变得轻松,但如果你是非技术用户想要定制复杂的爬虫,预计会有一定的学习曲线。
非常适合在不管理基础设施的情况下扩展数据采集规模,但一些小众商店的Actor在维护和可靠性方面可能参差不齐。
常见问题
使用 Apify 进行网页抓取合法吗?
网页抓取在提取公开数据(如价格或评论)时通常是合法的,Apify 提供的基础设施可以通过遵守 robots.txt 文件、避免绕过密码等技术屏障来合乎道德地完成这项工作。
什么是 Apify Actors?
Actors 是执行网页抓取和自动化任务的无服务器云程序;它们可以手动运行、通过 API 运行或按计划运行,并根据任务的复杂程度自动扩展。
Apify 如何应对反爬虫防护措施?
Apify 使用先进的技术来绕过封锁,包括浏览器指纹伪装、住宅代理轮换,以及使用 Crawlee 等专用库来模拟人类行为并避免 IP 速率限制。
我可以通过在 Apify 上构建的爬虫程序赚钱吗?
可以,开发者可以将自己定制的 Actors 发布到 Apify 商店,并通过一种货币化机制赚取被动收入,即客户为使用该工具所需的计算资源或特定用量付费。
Apify 是否为定制的企业解决方案提供支持?
Apify 为企业客户提供专业服务,包括全托管的数据提取解决方案、专属客户经理,以及来自其内部专家团队的定制开发。
如果我超出了套餐的使用限额会怎样?
一旦你的预付额度用完,你的使用将受到限制以防止意外收费,但你可以在计费控制台中启用按量付费(超额)设置,以固定单价继续运行任务。