
RunPod
开发者工具更新于 2026年10月4日
RunPod是一个可扩展的云平台,提供按需GPU资源以及用于AI模型训练和推理的无服务器端点。
通过我们的链接注册时,我们可能会获得佣金。这不会影响我们的评测。
什么是 RunPod?
RunPod 作为一个全球分布式 GPU 市场运作,你可以按小时租用高端计算能力来启动 Stable Diffusion 实例或训练 LLM,而无需承受企业云合同的负担。它通过将你连接到由私人提供商和数据中心运营商组成的网络,绕过了本地硬件的稀缺问题,让你能够在几秒钟内在 RTX 3090 或 A100 上部署 Docker 容器。我注意到其用户界面注重速度,但由于 Spot 实例市场的存在,如果有人出价更高,你的 Pod 可能会消失。这一点很重要,因为与固定价格的超大规模云服务商相比,它大幅降低了 AI 实验的成本。使用社区维护的模板可以快速上手,但如果你的训练运行不能容忍中断,请切换到专用实例。
如何开始使用 RunPod?
首先,注册 RunPod 控制台账户并验证你的电子邮件地址。你需要立即充值,因为该平台采用预付费模式。最低充值金额很低,非常适合在无需大笔投入的情况下测试单个 RTX 4090。按小时租用高端计算能力,而不必购买五位数价格的工作站,从而降低了训练小众模型或运行计算密集型推理的门槛。
提示: 立即启用双重验证以保护你的余额。接下来,浏览“GPU Cloud”或“Serverless”部分以选择你的硬件。你可以选择特定的显卡,如 A100,或者选择由社区提供的更便宜的实例。每个“Pod”都需要一个模板;官方 PyTorch 模板通常最适合 AI 工作负载。这样可以避免手动安装 CUDA 驱动的噩梦。预配置环境让你可以在几分钟内开始编程,无需调试内核不兼容问题,不过社区 Pod 的可靠性可能不如安全数据中心中的 Pod。
要点: 在部署之前检查 VRAM 需求,以避免在较小显卡上出现显存不足错误。启动你的 Pod,并等待约六十秒让容器完成初始化。你可以通过基于网页的 Jupyter Lab 连接,或使用 SSH 进行本地 IDE 集成。我更喜欢 SSH 方式,因为这样我可以直接在远程 GPU 上使用 VS Code 扩展。这样一台普通笔记本电脑就变成了一台专用的 AI 机器,既有本地编辑的响应速度,又有远程 H100 的原始计算能力,还有适合复杂脚本的专业终端。
要点: 将你的 SSH 公钥保存在 RunPod 设置中,以便每次连接时跳过密码提示。最后,如果你想在多个会话之间保留数据集,请使用网络卷来管理数据。常规 Pod 存储是临时性的,因此任何未存放在卷中的内容都会在你终止实例时消失。这种配置可以保护你的权重和日志,即使你从用于调试的低成本 GPU 切换到用于训练的高性能 GPU。代价是存储本身需要一些持续的低成本费用。持久卷将你昂贵的计算能力与你宝贵的数据解耦,因此一次常规关机不会让数天的训练进度付诸东流。
要点: 始终将 Pod 设置为“停止”以节省费用同时保留数据,但只有在完全完成后才“终止”它。
适合哪些人?
独立研究者
你需要高端 NVIDIA 显存来训练自定义 LoRA 或微调 LLM,而不必支付个人工作站五位数的价格。通过按小时租用 A100,你可以在原本无法企及的硬件上测试假设。对于与风险投资支持的实验室竞争的独立实验者来说,这创造了公平的竞争环境。
推理工程师
你想为一个生成式 AI 应用托管 API,只有在有人实际调用端点时才产生费用。无服务器 GPU 会在流量高峰时启动容器,并在流量低谷时重新缩减为零。应用空闲时,云账单不再侵蚀你的利润。我注意到 FlashBoot 技术将冷启动时间缩短到仅几秒钟,使其适用于实时应用。
Docker 高级用户
如果你的环境已经容器化,你可以在约六十秒内将特定堆栈部署到远程 GPU。这绕过了在本地 Linux 发行版上手动安装 CUDA 驱动的“依赖地狱”。你可以把时间花在编写 Python 代码上,而不是调试内核不兼容问题。缺点是你需要在网络卷方面保持严谨,以持久保存数据。
VS Code 开发者
你更喜欢本地 IDE,但需要远程 H100 集群的原始计算能力。通过 SSH 连接,你的标准笔记本电脑会变成一台配备完整终端访问权限和扩展支持的专用 AI 机器。本地响应速度与数据中心级的性能兼得。我发现提前设置 SSH 公钥可以消除反复输入密码的麻烦。
Stable Diffusion 爱好者
你想使用 ComfyUI 或 Automatic1111 批量生成高分辨率图像,而不给家用 GPU 增加负担。借助预配置模板,你可以在几分钟内在 RTX 4090 上启动 Web 用户界面。ControlNet 或 IP-Adapter 等复杂工作流的迭代速度也快得多。它非常适合密集的创意会话,但对于偶尔生成单张图片的提示词来说则不太理想。
RunPod 定价
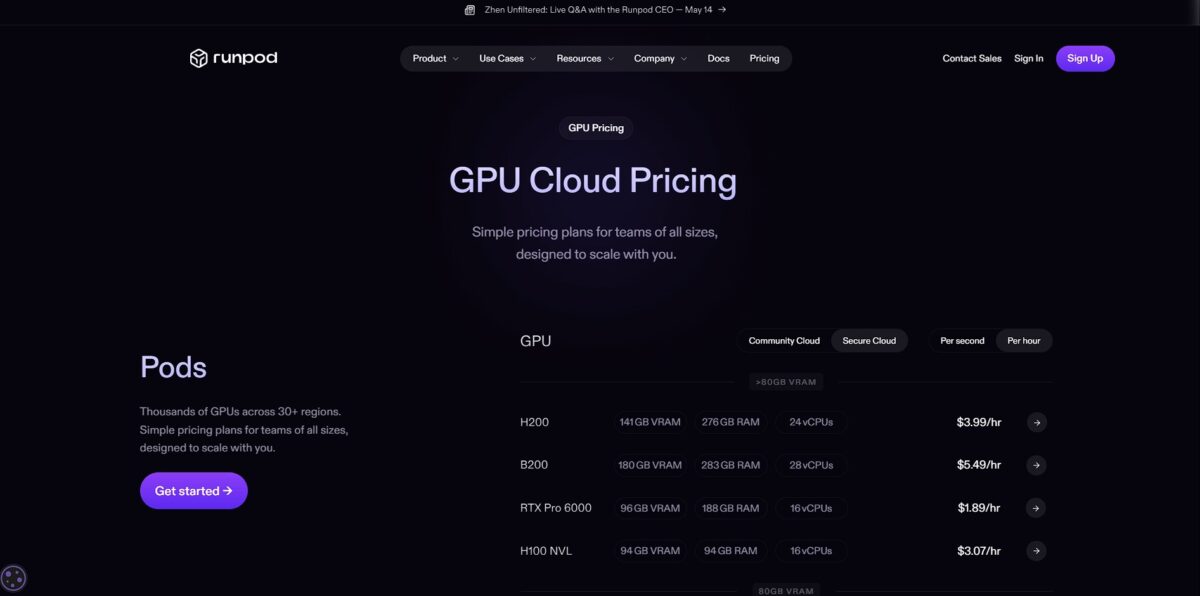
RunPod 放弃了统一的月度订阅制,转而采用基于市场的模式,让你按秒或按小时租用 GPU 时间。这种模式让你无需承受传统云服务商的高额加价,就能使用 H100 或 A100 等高端硬件。用多少付多少,因此在长时间的训练间隙,闲置实例不会白白耗费资金。缺点是价格波动性;成本会根据当前网络需求和你选择的定价层级而变化。
这些 Pod 在你删除之前一直属于你。这为复杂的开发工作提供了稳定的环境,没有突然终止的风险。
只需在代码实际运行时付费,这非常适合在流量回落后立即缩减为零的推理 API。
虽然计算成本会下降,但存储费用仍是独立的固定支出。即便如此,可预测的账单仍有助于团队为长期模型托管进行预算规划。
一个重要的“陷阱”是,已停止的 Pod 的存储费用会按双倍费率(每 GB 每月 0.20 美元)收取,以防止闲置资源的囤积。这项政策迫使你严格管理数据。
RunPod 主要功能
按秒租用 NVIDIA H100 或 A100 等高端 GPU
你可以避免巨额资本支出,因为你只需为模型训练实际消耗的计算周期付费。无法负担 40,000 美元硬件机架的独立研究者,也能用上同等级别的硬件。
启动在空闲时缩减为零的无服务器端点
你的 API 在流量高峰时保持响应,但一旦请求停止,就不再产生费用。再也不会因数据中心闲置算力而遭遇“账单冲击”。
部署自定义 Docker 容器,或使用预配置的 PyTorch 和 Jupyter 模板
你可以绕过安装 CUDA 驱动的“依赖地狱”,直接在 Notebook 中开始工作。从想法到运行基准测试所需的时间因此缩短了数小时。
在多个 Pod 之间挂载持久性网络存储
即使你更换 GPU 类型或重启 Pod,你的训练检查点和大型数据集仍保持可用。这一点很重要,因为它确保在 Spot 实例被抢占时,你不会损失数天的进度。
访问 Community Cloud 以获得更便宜的价格,或访问 Secure Cloud 以满足合规需求
你可以在利用闲置容量获得最大节省或使用专用硬件保护敏感数据之间做出选择。如何在价格与隐私之间取舍,由你自己决定。
使用 Flash CLI 直接将 Python 函数发布到云端
你可以避免构建和管理镜像,将编排工作交给平台处理。这样你就能专注于应用逻辑,而非基础设施。
RunPod 优缺点
优点
当超大规模云服务商显示“缺货”错误时,RunPod 依然能提供 GPU。你无需等待销售沟通,也不用苦等配额审批。不到一分钟即可启动一台 H100 或 RTX 4090。按秒计费确保脚本一结束你就停止付费。其无服务器端点可以缩减为零,从而消除了闲置成本:只需为实际使用的算力付费。追求稳定请选择 Secure Cloud,追求最大程度节省则选择 Community Cloud。
缺点
市场模式在稳定性上有所取舍。Community 实例折扣力度很大,但容易被突然抢占。如果有人出价高于你,你的训练任务可能会被中断,因此需要使用持久化存储卷来频繁保存检查点。它缺少 AWS 或 Google Cloud 那样完善的服务生态,这里没有托管 SQL 数据库或企业级网络。请务必挂载网络卷,以防 Pod 意外关闭导致数据丢失。
如果你想要以下功能,请使用 RunPod……
- 以按秒计费的方式租用高端GPU进行AI训练。
- 部署无服务器推理端点,无需管理基础设施。
- 立即访问用于大型模型的H100或A100集群。
- 运行具有完整root和SSH访问权限的持久化Pod。
- 轻松在全球范围内扩展生产环境中的AI工作负载。
- 利用社区提供的低成本算力对LLM进行微调。
- 实时监控GPU温度和显存使用情况。
- 凭借透明的按秒计费,避免复杂的云合约。
RunPod 替代方案
RunPod 用户评价
非常适合AI开发。在支持CUDA和GPU的工作环境中工作非常重要,而RunPod通过简单的安装提供了这一点。
出色的用户界面和即用型GPU。对于中端价位的云托管服务来说,这是最佳选择。
易于使用,且在这个价位上质量最佳。与大型供应商相比,联系客服支持也相对简单直接。
非常适合初创公司。它真的很灵活且易于使用。你可以轻松部署即用型模板并立即开始使用。
常见问题
Secure Cloud 和 Community Cloud 有什么区别?
Secure Cloud 运行在具有企业级可靠性和安全性的高端数据中心中,而 Community Cloud 使用由单个 GPU 提供商组成的点对点网络。Secure Cloud 更适合生产工作负载和敏感数据,而 Community Cloud 为非关键的开发和测试用途提供了明显更低的价格。
持久存储如何运作?
使用 RunPod,你可以创建可挂载到 Pod 的网络卷。这些卷可确保即使 Pod 终止或重启,你的数据、模型和代码仍然可用,同时你只需为实际使用的存储空间付费。
什么是 Spot 实例?
与按需定价相比,Spot 实例的价格有大幅折扣。缺点是,如果按需用户需要该容量,它们可能会被提前终止。因此,它们非常适合容错训练任务,但不太适合需要长期运行的 Web 服务。
我可以使用自定义 Docker 镜像吗?
是的,你可以使用来自 Docker Hub 或 GitHub Container Registry 等镜像仓库中的任何公共或私有 Docker 镜像来部署 Pod。这样你就可以使用特定的驱动程序、库或应用程序代码预先配置你的环境。
RunPod 支持无服务器部署吗?
是的,使用 RunPod Serverless,你可以将 AI 模型部署为端点,在不使用时可自动缩减到零。你只需为处理每个请求所需的确切 GPU 计算时长付费,这对于流量变化较大的推理任务非常经济高效。
如何管理多 GPU 集群?
RunPod 提供 Instant Clusters,让你可以部署具有高速互连的多个节点。这专为大规模模型的分布式训练而设计,此时单个 GPU 的内存已不足以满足需求。


