Semantic Scholar
数据分析更新于 2026年10月4日
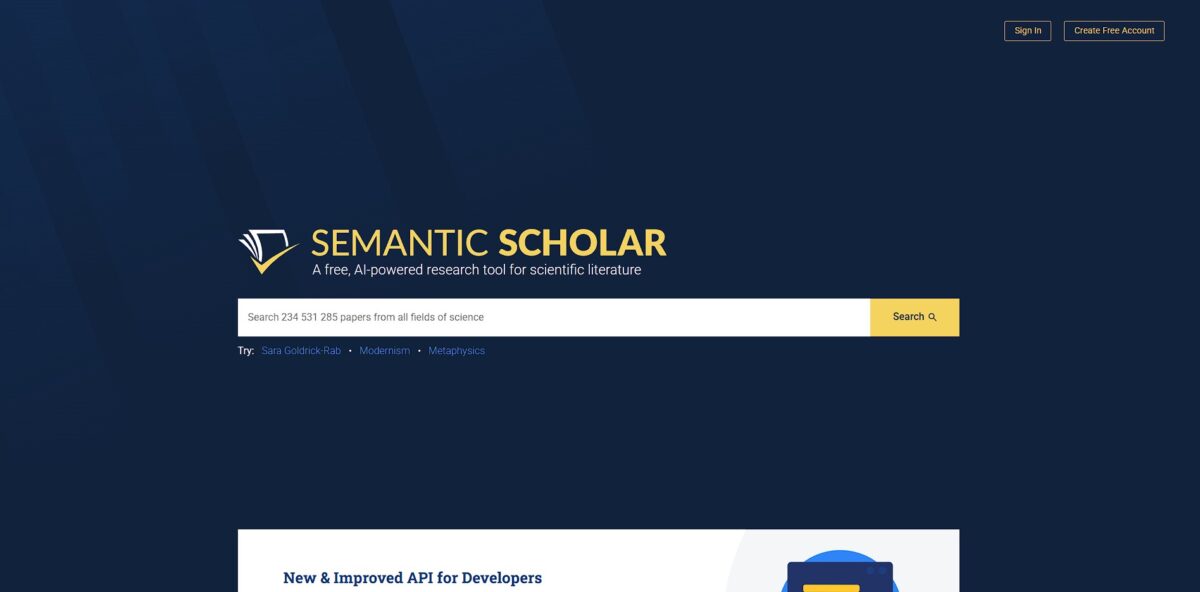
Semantic Scholar是一个免费的、由人工智能驱动的搜索引擎,它利用机器学习来发现和总结科学研究成果。
通过我们的链接注册时,我们可能会获得佣金。这不会影响我们的评测。
什么是 Semantic Scholar?
Semantic Scholar 是艾伦人工智能研究所(Allen Institute for AI)推出的一款非营利搜索引擎,它爬取了超过2亿篇论文,帮助你省去手动阅读冗长摘要的繁琐工作。它并非仅仅进行关键词匹配,而是利用机器学习提取引用背后真正的意图,标记出哪些论文真正影响了某项研究,而不仅仅是在列表中出现。我注意到它在计算机科学和生物医学领域尤其擅长呈现“TLDR”摘要,但对小众人文学科的覆盖则显得较为薄弱。这种语义化方法帮助你梳理一个研究领域的演变,而不会被每年发表的三百万篇论文所淹没。它将大段文字转化为一张可导航的关联图谱,让你更快找到“必读”文献。
如何开始使用 Semantic Scholar?
首先访问 semanticscholar.org 试用搜索栏。你不需要注册账号即可浏览其超过2亿篇论文的语料库,这对于快速核实事实非常有用。输入具体主题,然后在结果中查找 TLDR 标签。这些一句话摘要能帮你在不打开PDF的情况下跳过不相关的内容。
若要更充分地利用这一引擎,点击右上角的“创建免费账户”。你可以使用 Google 账号或你所在机构的邮箱注册。这将解锁“文库”功能,你可以把论文保存到特定文件夹中。这能防止你的研究资料变成一堆杂乱无序的浏览器标签页。
保存了一些论文后,将这些文件夹的“研究推送”开关打开。AI 会分析你的收藏,每天推荐新的相关预印本和文章。这就像一个了解你研究兴趣的个性化发现队列。这能让你省去每周重复相同关键词搜索的麻烦。
如果你是作者,可以在搜索结果中找到自己的名字,并选择“认领作者页面”。这样你可以整理自己的出版记录,删除并非本人所写的论文,或补充遗漏的论文。你还会在有人引用你的作品时收到通知。这是一种省时省力地追踪自己学术影响力的方式,无需为引文管理工具付费。
该网站在查找开放访问PDF方面表现出色,但有时“高影响力引用”数量与 Google Scholar 存在差异。这是因为它们侧重于特定的数据来源,而非整个网络。可以先将其作为发现工具使用,如果需要精确的引用总数,再到其他平台核实。
适合哪些人?
面对堆积如山PDF的研究生
TLDR 功能能从复杂的计算机科学或生物学论文中提取一句话摘要,让你不必阅读整篇摘要就能判断一项研究是否相关。你在文献综述中筛除无关信息的时间会大幅缩短。
追踪特定思想脉络的博士生
影响力评分能突出显示哪些引用真正塑造了一篇论文的方向,而不只是在引言中被一笔带过。了解一篇论文的“影响力”有助于你梳理某个概念数十年来的真实演变。你不会迷失在一堆泛泛的引用之中。
构建学术应用的开发者
开放API能稳定访问一个由海量论文元数据和引用关系组成的巨大图谱,而无需受制于传统数据库的门槛限制。你可以利用其索引数据集构建自定义研究工具或数据可视化。这正是在开放科学领域进行创新所需的原始数据。
应对信息过载的早期研究人员
个性化研究推送会根据你在文库文件夹中保存的内容推荐新论文,就像一个了解你研究细分领域的发现引擎。它自动完成“每日搜索”,让你在人工智能等快速发展的领域也不会错过突破性进展。保持信息同步变成了一个后台过程,而不是手动的苦差事。
协作研究实验室
共享文件夹让团队能够汇集相关文献并批量导出引用,确保团队项目中所有人步调一致。它弥合了个人发现与团队知识管理之间的差距。从此告别“你看过那篇论文了吗?”这样的邮件往来。
预算有限的独立学者
该平台免费提供超过2亿篇涵盖STM学科与社会科学的论文,成为昂贵专有索引的专业级替代方案。你可以享受高端自然语言处理功能,而不需要大学补贴的订阅服务。高水平的科学发现工具不再是资金雄厚机构的专属特权。
Semantic Scholar 定价
大多数学术搜索引擎最终都会把最好的功能锁在付费墙后面,但 Semantic Scholar 始终保持开放。由于它由艾伦人工智能研究所资助,你无需订阅即可使用深度引用图谱和论文摘要功能。
核心平台对所有人免费。
标准研究使用无需付费。公共端点在所有未经身份验证的用户之间共享每秒1000次请求的速率限制。
需通过协议获取。虽然网站没有列出分级定价,但需要专用吞吐量(起始为每秒1次请求)的开发者必须申请API密钥。
开放。你可以下载批量数据集用于本地分析,无需支付授权费用。你可以构建自定义研究工具或脚本,而不必担心每月账单。虽然API是免费的,但未经身份验证的层级在高峰时段可能会受到限速,因此如果你计划为项目抓取数据,最好申请一个免费的API密钥。
Semantic Scholar 主要功能
AI生成的TL;DR能用一句话精准概括论文的主要贡献
你可以浏览数十条搜索结果,而不必打开多个标签页去寻找核心论点。这能避免为了判断一项研究是否相关而啃读艰深摘要所带来的精神疲劳。选择那篇摘要最贴合你需求的论文,开始深入研究。
该引擎优先考虑有影响力的引用,而非单纯的引用数量,通过识别一篇论文是在前人工作基础上进行拓展,还是仅仅提及前人工作,来做出判断
你可以看到哪些研究真正推动了该领域的发展。这能帮助你跳过“背景噪音”,专注于塑造当前方法的基础文献。使用“高影响力引用”筛选功能,找出真正的重量级文献。
自动化研究推送会根据你文库中特定的技术方向,推荐新的预印本论文
它能捕捉到宽泛关键词提醒常常遗漏的小众论文。这能让你省去每周在不同期刊中手动搜索的麻烦。每周查看一次你的文库,看看推荐内容随着你添加更多文献如何演变。
Semantic Reader 在你阅读PDF时,会就地高亮显示关键术语和引用
它会调出定义和交叉引用,无需你滚动到参考文献部分查找。这能让你在遇到陌生缩写或复杂数学公式时保持阅读流畅。将鼠标悬停在引用上即可立即查看摘要,而无需跳转页面。
该平台直接链接到与研究相关的开放访问版本和GitHub代码库
你可以用两次点击,从理论主张跳转到实际实现或原始数据。这弥合了阅读方法与尝试复现之间的差距。留意“代码”按钮,看看作者是否发布了其技术栈。
作者页面覆盖数百万份作者档案,汇总每位研究者整个职业生涯的影响力和合作网络
这让你更容易审查一位研究者的持续产出,并找到其常见的合作者,从而更全面地了解一个实验室的产出情况。这为判断一项突破是偶然成果还是持续研究项目的一部分提供了背景信息。关注一位主要作者,追踪其在不同发表平台上的最新成果。
Semantic Scholar 优缺点
优点
Semantic Scholar 为数百万篇论文附上一句话的 TLDR,把你破译学术腔的时间压了下来。你不必开二十个标签页去啃密不透风的摘要,扫一遍搜索结果页就能看出哪些研究真正支撑你的论点。我注意到“高影响力引用”筛选能有效滤掉顺带一提的引用,只留下真正改变了某个领域走向的研究。这一点很重要,因为它避免你把参考文献建立在浮泛的引用之上。用于计算机科学和生物学的快速文献梳理很顺手,不过在小众人文领域,收录程度参差不齐。引用之前,先看引文语境片段,弄清这篇论文是被支持还是被质疑。
缺点
文库功能比较朴素,缺少专业文献管理软件里那种深入的 PDF 批注能力。研究推送的 AI 推荐一直挺贴题,但引擎有时会漏掉尚未收进主语料库的最新预印本。速度的代价是:当多个 AI 生成的模块争抢版面时,搜索界面会显得拥挤;而且当你不是在探索、而是要找一篇已知的具体文献时,繁杂的界面反而碍事。对需要把数千份本地文件集中存放的研究者来说,它并不合适。把它当作发现层来用,而不是唯一的文献整理工具。
如果你想要以下功能,请使用 Semantic Scholar……
- 用AI揭示数百万篇论文之间的隐藏关联
- 跳出关键词匹配,获得真正的语义搜索结果
- 一句话摘要,快速筛选你的阅读清单
- 自动引用追踪,监控你的研究影响力
- 通过智能数据驱动排名发现有影响力的论文
- 最新学术突破的个性化推送
- 在热门研究主题成为主流之前发现它们
Semantic Scholar 替代方案
Semantic Scholar 用户评价
现有最好的文献检索工具;AI摘要为我节省了大量阅读时间。
常见问题
Semantic Scholar 如何计算引用次数?
Semantic Scholar 根据其语料库中可获得的数据识别引用论文,该语料库主要关注已发表的学术文章和预印本。由于书籍收录有限且不包含专利,引用次数可能与其他网站有所不同。
什么是TLDR摘要?
TLDR是使用人工智能生成的超简短摘要,突出论文的主要目标和结果。它们旨在帮助研究人员快速浏览论文,以确定其是否与自己的工作相关。
该平台上的H指数是如何确定的?
H指数是使用Semantic Scholar数据库中可发现的引用数据计算得出的。它表示满足“有 h 篇论文各自至少被引用 h 次”的最大 h 值。
什么是高影响力引用?
此功能使用机器学习模型来识别被引出版物对引用论文产生重大影响的引用。它帮助研究人员从大量引用中筛选出最有意义的联系。
我可以保存和整理研究论文吗?
可以,创建免费账户后,你可以将论文保存到个人文库,将它们整理到自定义文件夹中,并与合作者共享这些文件夹。
什么是研究推送(Research Feeds)?
研究推送是基于人工智能的个性化推荐,根据你保存到文库文件夹中的内容推荐新论文。系统会随着你对推荐论文相关性的评分而了解你的兴趣。
如何找到我的Semantic Scholar ID?
你可以在网站上搜索自己的作者主页来找到你的ID。该ID是位于该作者主页URL末尾的数字字符串。
是否有面向开发者的工具?
Semantic Scholar提供RESTful API和Semantic Scholar学术图谱(S2AG)数据集,使开发者能够将学术内容和引用数据集成到他们自己的应用程序中。