WaveSpeedAI
艺术生成更新于 2026年10月4日
WaveSpeedAI是一个高速推理引擎,汇集了1,000多个模型,用于专业级图像、视频和音频生成。
通过我们的链接注册时,我们可能会获得佣金。这不会影响我们的评测。
什么是 WaveSpeedAI?
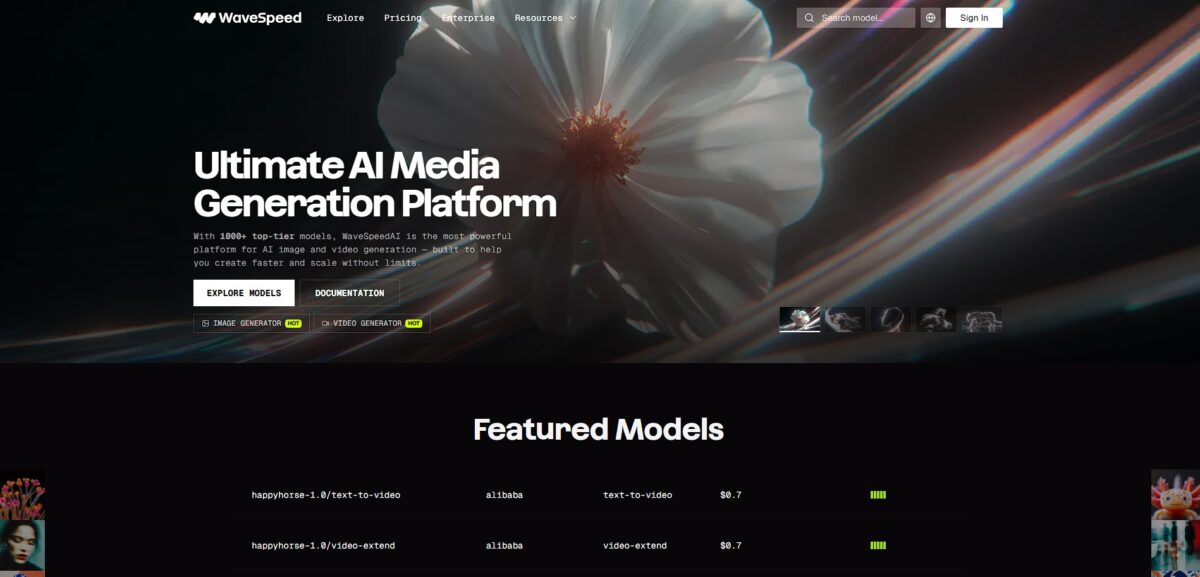
WaveSpeedAI 是一个统一的推理引擎,聚合了 1000 多个模型,让你可以通过单一的 API 或桌面应用生成图像、视频和音频。它消除了管理如 Flux 或 Kling 等工具的独立订阅带来的麻烦,将它们集中到一个工作空间中。该平台针对的是需要为批量任务提供亚秒级生成速度的开发者和高级用户,而不是随意浏览的普通用户。在实际使用中,你可以自动化复杂的流程,比如将文本提示转变为带有同步音频的脚本化视频,而无需在不同的浏览器标签之间切换。虽然它为 Python 和 JavaScript 环境提供了深度的技术控制,但选项的密集程度可能会让只想要简单社交媒体滤镜的人感到不知所措。这种设置为你提供了直接访问原始计算能力的途径,而没有通常的冷启动或硬件限制问题。
如何开始使用 WaveSpeedAI?
前往 wavespeed.ai,使用你现有的 Google 或 GitHub 账户进行身份验证。你在这里找不到传统的“注册”表单;该平台完全依赖第三方登录来省去密码管理的麻烦。新账户通常会获得少量试用积分,让你无需花钱就能测试大部分模型。这些积分足以让你在投入任何资金之前,验证特定的角色动画或音频转换模型是否真正符合你的需求。
进入平台后,导航到模型页面浏览模型库。这个界面感觉更像是一个仓库,而不是简单的艺术画廊,有清晰的标签用于试玩测试和 API 文档。你选择一个模型,输入提示或上传文件,然后点击运行以在预测标签中查看结果。这种方式对于快速原型开发很有效,但如果你不习惯在图像旁边看到 JSON 模式,可能会感觉有些技术性。好的一面是,它弥合了创意实验与生产就绪代码之间的差距。
如果你是开发者,在添加少量余额后,从仪表板获取你的 API 密钥。WaveSpeed 使用标准的 Bearer 令牌认证,所以你只需在 HTTPS 请求的授权头中传递你的密钥。我注意到试玩场甚至根据你当前的设置提供现成可用的 cURL 和 Python 代码片段,这在从浏览器测试转向本地脚本时节省了时间,因此重复的放大或语音生成任务无需手动点击即可运行。
试玩场包括一个位于输入框旁边的实用提示增强工具。每次使用只需几分之一美分,它会将基本描述重写为详细的指令,帮助 AI 避免诸如背景模糊或人体结构错误等常见问题。你每次生成要多付一点钱以获得更好的初始结果,但由于技术逻辑第一次就正确,你需要付费的失败渲染会更少。
适合哪些人?
API 开发者
这是一个供工程师使用的试玩场,他们需要将音频驱动的视频或图像放大直接接入自己的技术栈。你可以省去管理 GPU 集群的基础设施麻烦。你的时间将用于应用的逻辑,而不是服务器维护。
技术内容创作者
它适用于那些需要将静态角色转变为用于开发日志或教程的“说话头像”的人。我注意到即使遇到通常会难倒简单模型的复杂技术术语,唇形同步依然表现良好,因此你不必在每次更新脚本时重新录制面部。
快速原型开发者
如果你正在为一个角色驱动的应用构建概念,你可以在几分钟内生成动画变体。该工具能一次性处理从文本到语音再到视频的转换,这对早期演示来说是极大的省时工具。利益相关者看到的是一个“活的”产品,而不是平面线框图。
电商自动化专家
你可以通过 API 自动化批量产品图片的清理和放大处理。它能去除照片中的背景噪点,同时保持产品本身纹理的清晰度,让成千上万商品的目录呈现一致的外观,而无需手动编辑。
AI 小说创作者
当你需要为剧本中的特定场景制作动画时,它在保持角色一致性方面表现出色。虽然它在处理短片段方面表现良好,但对于非常长的序列,保真度会略有下降。尽管如此,你仍可以构建连贯的视觉叙事,而不会让主角的脸每三秒就发生变形。
本地化团队
它让你可以更换音轨,为同一段说话视频制作多语言版本。该引擎会将唇部动作重新同步到新的音素,看起来比标准配音自然得多。你的内容在全球观众看来就像本地原创,而不是翻译过来的。
WaveSpeedAI 定价
WaveSpeedAI 跳过了传统的订阅模式,采用按需付费的积分系统。你为账户充值,只需为触发的特定模型所使用的确切计算量付费。这种设置避免了每月为只用了三次的席位付费这一常见烦恼。
平台会为你提供 1 美元的免费积分作为起始,这大约能覆盖使用最经济的 Z Image Turbo 模型进行的 500 次生成。价格会根据模型的复杂程度浮动;例如,一张 Seedream 4.5 图像的成本为 0.04 美元,而一秒高端 Kling 3.0 视频的成本为 0.084 美元。语言模型的成本遵循标准的按令牌计价方式,Gemini 3.1 Pro 每 1K 输入令牌的价格为 0.00125 美元。如果你需要原始算力,无服务器 GPU 租用如 RTX 4090 每小时费用为 0.49 美元。这种细粒度让你可以从单一原型扩展到大规模批处理任务,而不会触及订阅上限。你的支出直接与项目的产出量挂钩。
WaveSpeedAI 主要功能
通过单一 REST API 访问 1,000 多个预优化的 AI 模型
你不再需要在不同的托管服务商之间寻找独立的 API 密钥,因为像 Seedream 4.5 和 WAN 2.6 这样的模型都集中在一个仪表板中。你可以在不管理五个不同计费账户的情况下,快速做出多模态应用的原型。
通过预加载的 GPU 实例消除冷启动
推理大约在 100 毫秒内开始,与社区驱动平台上 30 秒的启动时间相比,这是一个巨大的解脱。这使得用户期望即时图像结果的实时应用得以实现,而不会出现扼杀用户留存率的“加载”等待。
使用多轨唇形同步在单一画面中为多个角色制作动画
与在处理重叠对话时表现不佳的标准工具不同,该系统让你可以为 3 到 4 个不同的面部分配独立的音轨。这使得创建复杂的对话场景成为可能,而无需繁琐的手动遮罩处理。AI 电影制作中最耗时的部分由此实现了自动化。
使用基于节点的可视化工作流编辑器执行复杂的 AI 流程
你可以构建自动化链,扫描目录、生成摘要,然后制作唇形同步视频。它的功能类似于面向智能体的本地技能服务器,尽管对非技术用户来说学习曲线更陡峭。你无需编写样板 Python 代码就能获得自定义逻辑。
使用内容感知放大技术重建缺失的视觉元素
该引擎不仅仅是拉伸像素并添加模糊,而是重建纹理,使低分辨率扫描图像在 4K 下显得清晰锐利。它在照片上效果最佳,而插画模型则能防止皮肤看起来像塑料一样。颗粒感严重的手机拍摄画面也能在专业显示器上使用。
部署 12 款无需 API 密钥即可运行的基于浏览器的创意工具
你可以直接在网页应用中免费获得背景去除、对象擦除和媒体转换功能。这是一个方便的快速编辑试玩场,但高分辨率视频导出最终将需要付费积分。你可以在投入完整集成之前,先测试“Segment Anything”逻辑。
WaveSpeedAI 优缺点
优点
WaveSpeedAI 出图不到两秒,还能用一张静态肖像生成十分钟长的数字人口播视频。你不必再为了给角色对口型或放大某一帧,在几个网页应用之间来回跳。我注意到 Infinite Talk 引擎在长时段里能保持稳定的面部同一性,实质上解决了短片 AI 视频里那种五官逐渐走样、破坏代入感的问题。这一点很重要,因为你可以一次成型地做出完整的视频课程或长篇社交内容,而不必花上数小时去抠像、拼接零散镜头。用多人对话功能,可以自动生成不同数字人之间的对白场景,无需手工对齐各条音轨。
缺点
当你要做大批量试验或成批渲染 1080p 时,积分机制就成了阻力。平台提供 FLUX、WAN 等丰富的模型选择,但你也放弃了本地 Stable Diffusion 环境里那种极为具体的微调控制。视频生成的令牌单价在 Lite 与 Pro 模型之间差异明显,按机构级的业务量来算,月度成本很难预估,而且在你敲定最终提示词风格之前,一连串失败的试渲染就可能把余额耗空。充值更多余额之前,先用初始的免费额度测一测:以你自己提示词的复杂度,究竟要吃掉多少令牌。
如果你想要以下功能,请使用 WaveSpeedAI……
- 将音频转换为生动、高保真的说话视频
- 为低分辨率旧素材进行清晰锐利的4K放大
- 由逼真语音模式驱动的流畅角色动画
- 通过强大的API集成专业视频生成功能
- 快速图像编辑和生成式视频创作工作流程
- 与面部动作同步的高级语音生成
- 自动化复杂的媒体操作和内容版本管理
WaveSpeedAI 替代方案

WaveSpeedAI 用户评价
音频与视频的同步效果非常流畅;它已成为我快速制作角色动画的首选工具。
常见问题
WaveSpeedAI 可以免费使用吗?
新用户无需信用卡即可获得1美元的免费试用额度来测试平台,不过部分高级模型可能需要付费余额。
我可以使用哪些类型的模型?
你可以通过单一API访问超过1,000个模型,涵盖图像生成、视频创作、音频合成、3D资产创建以及头像唇形同步。
WaveSpeedAI是否支持商业用途?
是的,该平台专为生产级工作流程而设计,用户通常保留其生成内容的商业使用权。
生成过程有多快?
优化后的图像生成通常在2秒内完成,而视频生成则根据复杂度和长度需要30到180秒。
我可以使用自己的自定义模型吗?
是的,WaveSpeedAI提供无服务器GPU基础设施,允许你部署和扩展自己的自定义模型,并按秒计费。
是否有移动应用可用?
是的,WaveSpeedAI提供适用于Android、Windows、macOS和Linux的跨平台应用程序,共享同一强大的推理引擎。
是否支持音频转视频生成?
是的,你可以将音频文件转换为电影级音乐视频或具有帧精确唇形同步和节拍感知编辑功能的说话头像视频。
开发者有哪些集成选项?
开发者可以通过统一的REST API、Python和JavaScript SDK,或通过ComfyUI和n8n等无代码工具进行集成。